不久之前,我们还生活在一个完全模拟的世界里。从电话到电视,从书籍到活页夹,数字技术基本上仅限于实验室之中。
但在20世纪60年代,计算机开始进入大型机构的后台办公室,承担会计、薪资和库存管理等职能。然而,当时绝大多数系统(如医疗系统、电网或交通网络)以及我们日常接触的技术,仍然是模拟的。
再过一代人的时间,如今我们的世界已高度数字化。0和1渗透进我们的生活。计算技术几乎已经渗入人类活动的每一个方面,从医疗保健、制造业,到电信、体育、娱乐和媒体。
以智能手机为例,它的出现还不到十年,但想想它已经取代了多少种模拟事物:街道指南、卡带播放器、笔记本、通讯录、报纸、照相机、摄像机、明信片、指南针、日记、录音笔、寻呼机、电话,甚至水平仪!
在这一切背后,当然是互联网的爆炸式增长。除了人类使用互联网之外,我们还看到一种更为普遍的应用,即把各类设备、机器和系统连接在一起——也就是所谓的 物联网 (或称“工业互联网”或“万物互联”)。
复杂系统
如今我们生活在一个大多数系统都已安装传感仪器、并产生海量数字数据的时代。对这些数据的分析,能够以过去在模拟世界中不可能实现的方式,为这些系统提供洞见。
数据科学正在整合统计学、机器学习、分析学和可视化等领域,为这一学科奠定严谨的基础。它的发展方式,与计算机科学在20世纪50年代兴起以支撑计算技术的方式如出一辙。
过去,我们已成功建立复杂的数学模型,用以解释和预测物理现象。例如,我们能够准确预测一座桥梁的强度,或化学分子之间的相互作用。
再说天气,它以难以预报著称。然而,基于数值天气预报模型、大量观测数据以及强大的计算机,我们已将预报准确率提升到这样的程度:如今的五天预报,与20年前的两天预报同样可靠。
但有许多问题,其底层模型并不容易界定。目前还没有一套数学方程能够刻画医疗系统或网络犯罪的模式。
不过,我们确实拥有越来越多的数据,它们来自无数来源。挑战在于,这些数据往往形式多样、来源各异、尺度不一,并且包含误差和不确定性。
因此,与其像建造桥梁或研究化学相互作用那样尝试建立确定性模型,我们可以建立数据驱动型模型。这些模型整合来自各种来源的数据,并能够将数据中的误差和不确定性纳入考量。我们可以针对具体假设检验这些模型,并对其加以完善。
同样至关重要的是,我们要审视这些模型以及支撑它们的数据。
360度数据
在我所在的大学,我们建有一个数据展厅(Data Arena),用于数据的探索与可视化。该设施利用开源软件、高性能计算以及电影视觉特效技术,将数据流映射为一套全沉浸式3D立体视频系统,将2400万像素投射到一块四米高、直径十米的圆柱形屏幕上。
站在这一设施中央、实时与数据互动,是一种颇具冲击力的体验。我们已经搭建起数据管道,用以接入高分辨率光学显微镜的数据,并帮助研究人员深入了解细菌如何在各类表面上移动。
我们读取了由CSIRO的Zebedee设备采集的2200万个数据点,该设备曾对Wombeyan Caves进行扫描;十分钟后,我们已经以三维视角飞越洞穴,在地下世界中探索。
无论我们探索的是哪一类数据,总会发现一些有趣的东西。
在少数情况下,数据中的错误一眼便能看出。在一个天文数据集中,我们发现存在大量重复数据点。在其他情况下,我们观察到了一些模式,而这些模式此前对分析这些数据的领域专家而言并不明显。
这种现象正是经典的“未知的未知”(因2002年时任美国国防部长唐纳德·拉姆斯菲尔德而广为人知),它凸显了人类视觉系统识别模式或异常的能力。
当今世界充斥着数据。它正在开辟新的可能性、新的研究途径和新的认知方式。但如果我们想充分利用这些数据,就需要能够管理如此庞大数据量的工具。我们的眼睛便是其中一种工具,但即便是它们,也需要像数据展厅这样的空间提供帮助。
本文与 The Conversation合作发表。刊发本文并不意味着世界经济论坛认同文中观点。
如需及时关注 The Agenda, 请订阅我们的每周电子通讯。
作者:Glenn Wightwick 是悉尼科技大学的研究副校长(Deputy Vice-Chancellor of Research)。
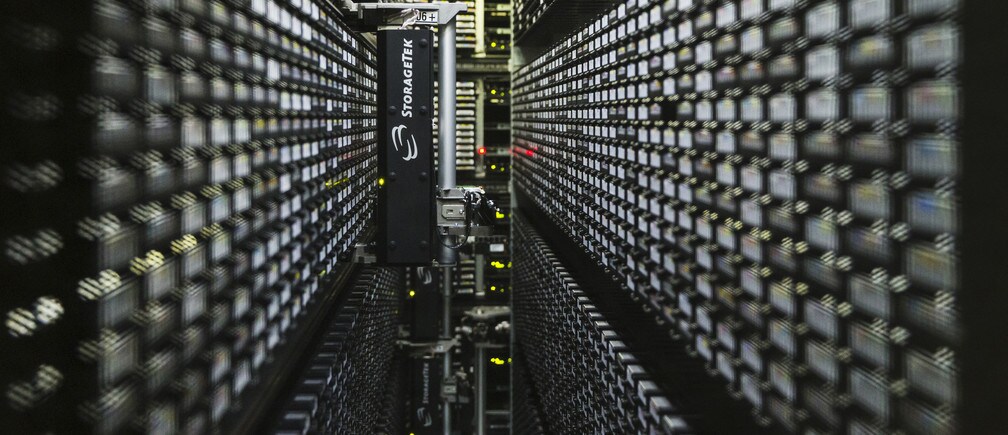
图片:2013年8月13日,德国柏林康拉德·祖泽应用数学与计算机科学中心(ZIB)内,用于数字数据海量存储的机器人磁带库。路透社/Thomas Peter。


