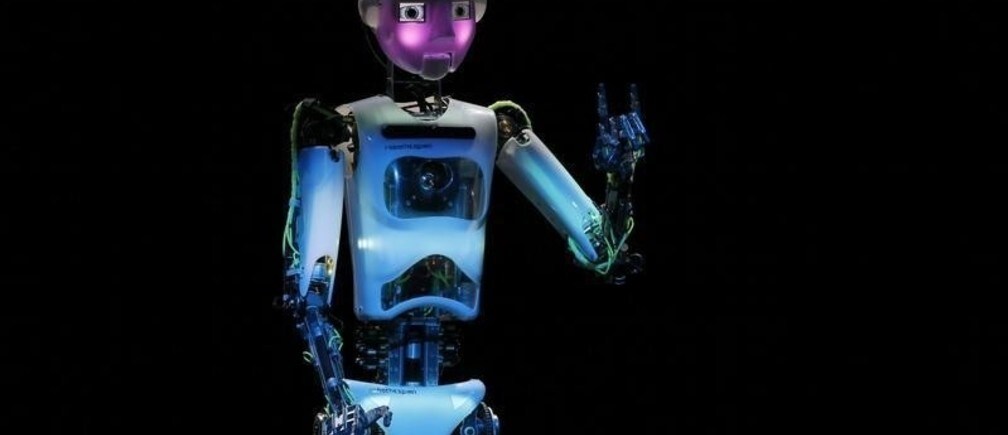
对未来的预测对我们的规划很重要,因此今天我将分享我对未来5年机器使用人类语言的看法。最近,我写过一篇文章,回顾十年前我提出的十大预测:随着以 IP 为中心的发展蓬勃兴起,这些预测已经成为现实。我还写道:“2020年至2025年间将由机器主导。消费者和企业将生活在一个机器人世界里——这一情景令人不寒而栗地让人想起《终结者》系列。”这种情形对我们来说进展如何?
创新已经发生、只需付诸应用时,科学预测最容易作出。我们非常擅长应用有效的技术,电视小型化和摩尔定律就是明证。相反,许多人在1956年达特茅斯会议上预测了智能机器的崛起;正是在那次会议上,“人工智能”(AI)一词被提出。大多数预测——例如语言间自动翻译、通用机器人以及与机器交谈——至今尚未实现,因为相关技术起初尚不成熟,而且解决方案的设计也受制于当时的限制。然而,在某些情况下,人们仍在继续追求最初的解决方案,却没有通过进一步创新来利用当今的技术。
澳大利亚公司 Thinking Solutions 发现,无需依赖当今占主导地位的机器学习方法——统计分析,也能够实现语言理解。不仅如此,在这一关键领域,已有证据表明机器可以达到类人的准确度,而这正是下一代机器所需要的。
概述
人类对话被视为人工智能领域的难题——也就是说,必须先解决人工智能的所有问题,才能实现对话。有人会认为,首先需要详细了解大脑中的每一项活动;但正如人工智能创立以来所见,大多数问题似乎都可以独立于整体解决方案而解决。对话问题可以拆解,因此我将逐一探讨这些拼图及其解决方案。
要处理语言,机器至少需要理解(a)文本,最好还能处理更多内容,包括(b)口语以及(c)口头回应的生成。目前有些技术从纯文本入手,依据规则挑出少数文本片段,然后将控制权交给应用程序:比如让汽车打电话回家。但在人类语言能力发展的下一步,机器需要(d)理解人们所说的话。母语者能捕捉句子中每一处细微的含义差别,并在必要时纠正我们的用词;这与当今的语言系统截然不同。
接下来,我们结合对话内容的理解和当前情境,利用(e)上下文来尝试澄清对方所说的话。在跟踪上下文的同时进行互动,就是我们所说的(f)对话。最后,在理解了所说内容之后,我们(g)采取行动。行动可以是记下信息但不作处理,也可以是实际移动,或决定如何口头回应:例如提出澄清问题,或给出信息性答复。
文本识别
文本识别始于通过键盘输入计算机的字母。有些分析止步于这一识别层面。
例如,IBM Watson 获取识别出的文本,利用复杂算法和专用硬件,从通过获取非结构化文档中的知识而建立的庞大知识库中,确定最相关的已知信息。可以把它理解为从文档中挖掘“大数据”,而非类人的认知,因为该系统并不理解词语。
语音识别
语音识别在科幻作品中一直很受欢迎,但在实际应用中,它仍远未达到人类水平的准确度。更糟的是,好莱坞开始设想我们的未来将局限于语音命令,科幻作品中的系统如今也以不自然的方式运作,比如:“打开音乐”或“打开水龙头”。直接说出脑海中想到的话,不是更容易吗?比如“把淋浴打开,让水暖和些,这样我走进浴室时就正合适?”
Nuance 是听写软件市场的领导者。其普及程度可能受到准确性的限制。如果你不敢把身家性命交给市场领先的听写系统,让它准确转录所听到的内容,那么这项技术就还没有准备就绪。自20世纪60年代末以来,许多人一直认为,语言理解的缺失阻碍了听写技术的发展。
语音合成
没有什么比听到糟糕的语音合成器更能让人想到科学进步的缺乏。历史上的问题之一在于系统缺乏语言表征;但要让任何语言的语音听起来自然、口音恰当,就必须知道词语和短语中哪里需要重读,以及音节应以何种速度发出。
语言理解
在当今行业中,语言理解仍是一个尚未解决的问题,现有方案也难以令人满意。人们常说,只要增加规则就能提高准确度,但问题最终会回到可扩展性上。所需规则的数量可能不断增长,直到超出程序员能够处理的范围。
相比之下,利用机器学习技术实现自动化,会通过自动分析文档来积累统计数据,但并不会提供词语的含义。深度学习是当前的一种方法,人们认为它可以进一步自动提取有用特征。谷歌目前正在投资深度学习应用,其投资对象包括该领域的创始先驱之一 Geoffrey Hinton 博士。
如今更强大的处理能力使这项技术成为可能,但相关概念早在20世纪80年代就已提出。有没有更好的方法,能在不耗费大量处理资源的情况下取得同样结果?与每个活动环节都被完全理解的工程方法相比,让机器收集特征并在不依赖人为参与的情况下独立应用这些特征的方法,哪一种更好?我个人更偏好后一种,即每个环节都以预先确定的方式稳定运作的工程化解决方案。
上下文跟踪
上下文跟踪是对话不可或缺的一部分,也是一个取得诸多进展的科学研究领域,但在大型企业中却遭到忽视。Thinking Solutions 科学顾问委员会成员 Robert Van Valin 教授以三个维度对语言建模:词序列(语法)、词义(语义)和对话(语用话语)。作为角色与指称语法的主要开发者,Van Valin 的模型通过一种链接算法促进对话中的上下文跟踪。
如今,工作原型中的链接算法能够将语言转换为其含义,并在对话中准确消除指代歧义。
对话
机器交互一直缺少对话这一环节,因为对话不仅要求理解所说的话,还必须处理当下正在发生的其他情况。如今,最先进的系统采用基于命令的解决方案,命令会产生可预测的回应。它们不像对话那样具有互动性。最近被 Facebook 收购的 Wit.ai 实现的就是此类基于命令的应用。Wit.ai 联合创始人 Alex Lebrun 的一段话概括了从命令迈向对话尚有多大距离,同时也指出目前不存在统一的解决方案:
“Wit.ai……只是触及了问题的表面。从简单命令开始,我们还需要教会机器理解更复杂的陈述、意识到上下文、处理严重的歧义,并生成自然流畅的互动。我怀疑我们会看到由一家公司独自提供的单一、庞大的解决方案。相反,会有几家初创公司分别解决问题中界定明确的部分。自然语言应用将由这些相互衔接的部分组成。”
采取行动
在对话的这一阶段采取行动并不复杂。一旦我们理解了对方所说的话,行动就能确定下来。对于大多数任务而言,这属于程序员的职责,是一种常见技能。
各种移动电话应用,例如个人助理,运作方式大体相同,功能也相似。它们如今都缺乏对话能力,但一旦确定了行动,都会给出一致且准确的回应。在无法理解的地方,从人类的角度来看,它们表现都同样糟糕。
讨论
今天的博客探讨语言系统需要具备哪些条件,才能满足当今机器理解的需求。人们对此兴趣浓厚。以计算机设计、二战密码破译以及人工智能先驱工作而闻名的 Alan Turing 博士设计了一项智力测试。该测试通过对话来判断对方是否具有智能。如今有人认为,回答问题是更好的测试方式,例如 Winograd Schema Challenge。这种测试现已成为 Nuance Communications 举办的一项竞赛;不过,当然,在图灵测试中,你也可以提出那些问题。
最近收购了 Wit.ai、并聘有多位人工智能专家的 Facebook 提出了一种更简单的测试。测试中会输入几个句子;母语者总能正确回答关于这些句子的问题,而测试要判断的是机器能否做到这一点。正如我所解释的,这项测试很好地体现了语言理解。
结论
在人工智能领域总体而言,尤其是在语言和语音产品领域,缺乏摆脱计算密集型统计技术的激进创新。转向实现基于含义的系统,不仅有望带来人们期待已久的人机对话界面,也将提供一个平台,开启计算发展的下一阶段。
当人类有解决方案可循时,我们的采用速度和创新能力一贯强劲。如今,2020年的预测看起来与2015年预测的结果一样有力。
处于这项发展前沿的我们,是否需要担心《终结者》系列中关于2020年的预测会成为现实?幸运的是,语言系统只是拼图中的一块——它对于提升我们在机器人世界中的体验至关重要——但终究只是一块。
本文与 LinkedIn合作发表。本文的发表并不意味着世界经济论坛认可其中的观点。
订阅我们的每周通讯,及时了解议程动态。
作者:Cyberflow Analytics 董事长兼首席执行官 Hossein Eslambolchi 博士。
图片:2014年3月9日,在汉诺威科技博览会 CeBIT 开幕式上,英国公司 RoboThespian 的人形机器人“脸红”了;英国是当年的合作伙伴国。路透社/Wolfgang Rattay


