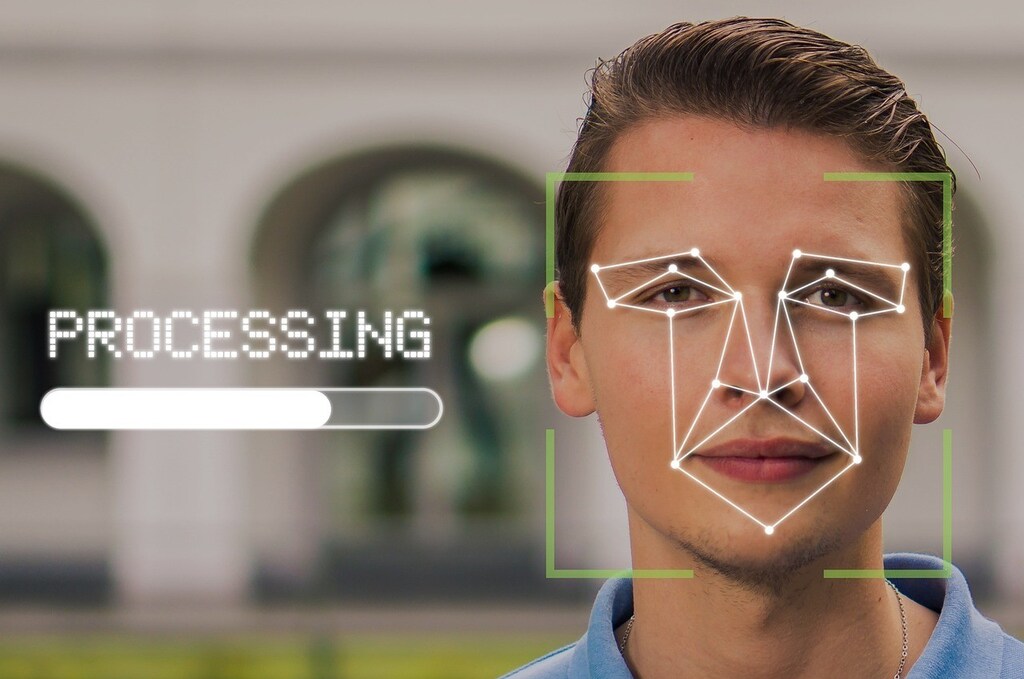
尽管人们普遍意识到AI算法存在偏见和错误的风险,科技公司的AI聊天机器人和图像生成器仍屡屡出错。
AI偏见的一个可能原因在于,训练数据来自缺乏代表性的群体,这导致准确性与公平性之间需要权衡取舍。
一位科技教授通过自己无意中创建有偏见AI算法的经历,强调了多元化对于打造包容性算法的重要性。
1998年,我无意中创建了一个存在种族偏见的人工智能算法。这个故事中的教训,在今天显得更加发人深省。
这些危险在于AI算法中的偏见和错误如今已广为人知。那么,为何近几个月来科技公司接连出错,尤其是在AI聊天机器人和图像生成器领域?ChatGPT的早期版本曾产生种族歧视性输出。DALL-E 2和Stable Diffusion图像生成器所生成的图片也都显示出种族偏见。
作为一名白人男性计算机科学家,我的顿悟发生在2021年教授一门计算机科学课程的时候。课上刚刚播放了Joy Buolamwini的一首视频诗歌,她是AI研究员兼艺术家,并自称代码诗人。她2019年的视频诗歌“AI,我不是女人吗?”是一部长达三分钟、极具震撼力的揭露性作品,剖析了自动人脸识别系统中的种族和性别偏见——这些系统由谷歌和微软等科技公司开发。
这些系统常常无法正确识别有色人种女性,并错误地将她们标记为男性。部分错误尤为严重:黑人民权领袖Ida B. Wells的头发被标记为“浣熊皮帽”;另一位黑人女性则被标记为留有“海象胡须”。
跨越岁月的回响
在那堂计算机科学课上,我经历了一次令人难受的似曾相识之感:我突然想起,自己也曾创建过一个存在种族偏见的算法。1998年,我还是一名博士生。我的项目旨在根据摄像头的输入追踪人的头部运动。我的博士导师此前已开发出数学技术,能在某些情况下准确追踪头部,但该系统还需要更快、更稳健。早在20世纪90年代初,其他实验室的研究人员已证明可以实时提取图像中的肤色区域。因此,我们决定将肤色作为追踪器的一个额外线索。
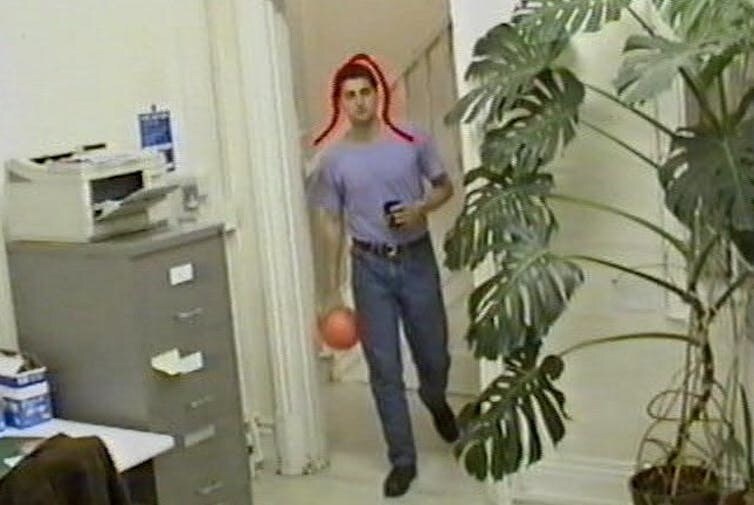
我使用了一台数码相机(在当时仍属罕见)拍摄了自己手部和脸部的几张照片,还顺手拍下了楼里恰好在场的两三个人的手和脸。手动从这些图像中提取部分肤色像素并构建肤色统计模型并不难。经过一番调整和调试,我们得到了一个出人意料地稳健的实时头部追踪系统。
不久之后,我的导师要求我向一些来访的公司高管演示该系统。当他们走进房间时,我顿时感到焦虑万分:这些高管是日本人。在我随意进行的实验中,为了检验简单的统计模型能否适用于我们的原型,我采集的数据只来自我自己和楼里恰好在场的少数几个人。然而,这些被采样对象100%都是“白人”肤色,而这些日本高管并非如此。
说来也巧,该系统对这些高管竟然也表现得相当不错。但我震惊地意识到,自己创建了一个存在种族偏见的系统,它很可能轻易就会在其他非白人群体身上失效。
特权与优先事项
受过良好教育、怀有善意的科学家,为何以及如何会开发出存在偏见的AI系统?社会学的特权理论为此提供了一个有用的视角。
在我创建头部追踪系统的十年前,学者Peggy McIntosh提出了白人所背负的“隐形背包”这一概念。背包里装满了各种特权,例如“我在具有挑战性的处境中表现出色,却不会被称为代表我种族的光荣”,以及“我可以批评我们的政府,并谈论我对其政策和行为的担忧,而不会被视为文化局外人”。
在AI时代,这个背包需要一些新的物品,例如“AI系统不会因为我的种族而给出糟糕的结果”。白人科学家的隐形背包还需要包括:“我可以基于自身外貌开发AI系统,并且知道它对大多数用户都会运行良好。”
针对白人特权,有一种建议的补救方式是积极反种族主义。就1998年的头部追踪系统而言,反种族主义的补救措施似乎显而易见,即平等对待所有肤色。的确,我们可以而且应当确保系统的训练数据尽可能平等地涵盖各种肤色。
遗憾的是,这并不能保证系统所识别的所有肤色都会得到平等对待。该系统必须将每一种可能的颜色归类为肤色或非肤色。因此,总会存在恰好位于肤色与非肤色边界上的颜色,计算机科学家称这一区域为决策边界。肤色跨越这一决策边界的人,将被错误地分类。
科学家在将多样性纳入机器学习模型时,还面临一个棘手的潜意识困境:多元化、包容性的模型,其表现反而不如狭隘的模型。
一个简单的类比可以说明这一点。设想你面临两项任务的选择。任务A是识别一种特定的树,比如榆树。任务B是识别五种树:榆树、白蜡树、刺槐、山毛榉和胡桃树。显然,如果练习时间固定,你在任务A上的表现会优于任务B。
同理,一个只追踪白人肤色的算法,会比一个能追踪全部人类肤色范围的算法更为准确。即便科学家意识到多样性与公平性的必要性,他们仍可能在潜意识中受到这种与准确性相互竞争的需求的影响。
隐藏于数字之中
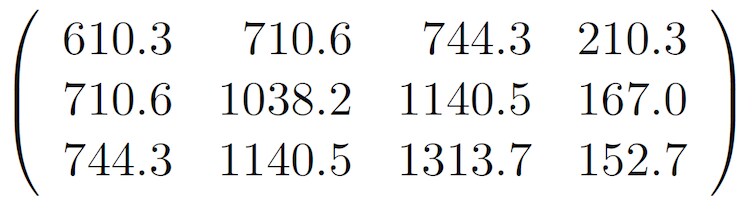
我创建有偏见算法的行为欠缺考虑,且可能带有冒犯性。更令人担忧的是,此次事件表明,偏见可以深藏于AI系统之中而不易察觉。要理解原因,不妨看看一组由12个数字组成的矩阵,它有三行四列。这些数字看起来有种族主义色彩吗?我在1998年开发的头部追踪算法正是由这样一个描述肤色模型的矩阵所控制的。但仅凭这些数字,根本无法判断这实际上是一个带有种族主义色彩的矩阵。它们只是由计算机程序自动生成的数字而已。
在现代机器学习系统中,隐藏在显眼之处的偏见问题要严重得多。深度神经网络目前是最流行、最强大的AI模型类型,其中往往包含数以百万计的数字,偏见可能就编码在这些数字之中。《AI,我不是女人吗?》一文所批评的存在偏见的人脸识别系统,全部都是深度神经网络。
好消息是,无论在学术界还是产业界,AI公平性方面都已取得了大量进展。例如,微软设有一个被称为FATE的研究小组,专注于AI领域的公平性、问责制、透明度和伦理。知名机器学习会议NeurIPS则发布了详细的伦理准则,其中包括一份八点清单,列出了向该会议投稿的研究人员必须考虑的负面社会影响。
谁在房间里,谁就有话语权
另一方面,即便到了2023年,公平性仍可能受到学术界和产业界竞争压力的冲击。谷歌和微软推出的存在缺陷的Bard和Bing聊天机器人便是这一严峻现实的最新例证。为了争夺市场份额,商业上的迫切需要导致这些系统被过早发布。
这些系统存在的问题与我1998年的头部追踪系统如出一辙:训练数据存在偏见;设计者来自缺乏代表性的群体;它们在数学上难以平等对待所有类别;它们必须以某种方式在准确性与公平性之间做出取舍;而它们的偏见则隐藏在数以百万计、难以审视的数值参数之后。
那么,自25年多前一名博士生可以在无明显监督或后果的情况下,设计并发表一个存在种族偏见的算法结果以来,AI领域究竟取得了多大进步?显然,存在偏见的AI系统仍然可能无意间被轻易创建。同样显而易见的是,这些系统中的偏见可能造成危害,难以察觉,更难以消除。
如今,人们常说产业界和学术界需要让多元化的群体“进入房间”参与这些算法的设计,这已成为陈词滥调。如果该领域能够达到这一目标,那将大有裨益。但现实是,北美计算机科学博士项目的毕业生中,女性仅占约23%,黑人和拉丁裔学生仅占3%,因此,将会有许多房间和许多算法,其中完全没有代表性不足群体的身影。
这正是我1998年头部追踪系统的根本教训在今天显得更为重要的原因:犯错很容易,偏见悄然潜入而不被察觉也很容易,而房间里的每一个人都有责任防止这种情况发生。




