AnyScale Learning For All(ALFA)研究组 隶属于 麻省理工学院计算机科学与人工智能实验室(CSAIL) ,旨在解决最具挑战性的大数据问题——这些问题超出了典型分析的范畴。ALFA 运用最新的机器学习和进化计算理念,针对涉及高维度的复杂问题开展研究。
“如今,人们通过许多不同渠道接收数据,”ALFA 主任、CSAIL 首席研究科学家 Una-May O’Reilly 说。“我们正在帮助他们连接并关联这些渠道之间的数据。”
ALFA 研究组承担的挑战包括规划风电场布局,以及研究和分类血压数据中的心搏,以预测血压骤降和飙升。该组还在分析海量记录的点击数据,以预测大规模开放在线课程(MOOC)的学习行为,甚至帮助美国国税局防范代价高昂的逃税骗局。
ALFA 更愿意挑战直接来自源头的原始数据。随后,它会运用多种技术研究这些数据,其中大多数涉及可扩展的机器学习和进化计算算法。
“机器学习非常有用,可以回顾历史数据,帮助你预测未来,”O’Reilly 说。“进化计算也可以用同样的方式,而且尤其适用于规模大、维度极高的问题。”
O’Reilly 说,过去,机器学习面临数据不足的挑战,难以据此推断预测模型或分类标签。“现在数据太多了,因此我们采用可扩展的机器学习,尝试处理海量数据样本,”她说。“我们还需要提升机器学习应对极高维问题所伴随额外变量的能力。”
O’Reilly 对 ALFA 的另一项主要工具——进化计算——特别感兴趣。“借鉴进化中的理念,例如基于种群的适应和遗传继承,并将它们融入计算模型,效果非常好,”她说。“在工程领域,我们常使用进化算法进行优化,例如协方差矩阵自适应算法或离散值算法。此外,进化算法几乎可以毫不费力地并行化,从而能够处理许多最新的数据知识发现问题。”
在进化领域中,O’Reilly 尤其关注遗传编程,或者按她的定义说,“程序的进化”。“我们将遗传编程算法分布到许多节点上,再把数据分配到各个节点,”她解释说。“我们把能够并行计算出的所有独立解汇集起来,然后淘汰较弱的解,并将较强的解集体融合,构建一个集成模型。我们已经证明,基于集成的方法比基于全部数据的单一模型更准确。”
规划风电场布局
ALFA 最成功的项目之一是开发用于协助设计风电场的算法。O’Reilly 说,这个问题具有极高维度,尤其是在涉及数百台风力涡轮机时。
“优化风力涡轮机的布局可以显著提高效率,但这是一个非常复杂的问题,”她说。“首先要考虑涡轮机本身的参数:发电量、高度和邻近范围。你必须确定场址所需的风力大小,然后收集更精细的信息,了解风从何处吹来、风量有多少。还必须考虑土地的地形条件,以及风如何掠过土地。”
O’Reilly 说,最难处理的变量是某台涡轮机对其后方涡轮机造成的尾流效应。“我们必须进行非常复杂的流场建模,才能计算出每台涡轮机后方的损失。”
ALFA 发现了如何应用并行化的进化算法,使其能够扩展到拥有一千多台涡轮机的风电场。“我们得以在比以往任何人都更大的规模上规划涡轮机布局,”O’Reilly 说。
最近,ALFA 一直在为场址设计构建生成式模板。“现在,我们正在运用进化理念开发一个程序,能够在任何场址布局任意一组涡轮机,”她说。“我们构建的是设计流程,而不是场址设计本身。”
GigaBEATS:读懂血压数据
许多用于规划风电场的进化和机器学习理念,同样可以用于从临床数据中获取洞见。ALFA 正尝试从医疗传感器收集的、不断增加的生理数据中提取有用信息。这些数据包括从睡眠模式到心电图(ECG)和血压等各种测量信息。
“临床医生很难理解如此大量的数据,”O’Reilly 说。“我们希望提取信号层面的信息,并将其与机器学习相结合,从而做出更好的预测。”
O’Reilly 说,研究人员往往只从少量样本中收集少量数据,并开展一项耗时超过 18 个月的研究。“我们想把这 18 个月缩短到几个小时,”她说。
ALFA 正在开展一个名为 GigaBEATS 的项目,从超大规模生理数据集中提取知识。该项目最初研究的是重症监护病房数千名患者的血压数据。
“我们正在检查每一次心搏的微观特征,”O’Reilly 说。“最终,我们会按历史片段汇总这些特征,从而预测血压飙升。”
ALFA 研究组创建了一个名为 BeatDB 的数据库,它收集的不仅是波形中的心搏,还包括“每次心搏的一组属性或特征”,O’Reilly 说。BeatDB 已存储了来自 5,000 多名患者的 10 亿个血压心搏特征。
“我们为每次心搏描述一组时间序列形态特征,”O’Reilly 解释说。“一旦建立起一套可靠的信号基础数据,我们就可以在此基础上提供技术服务,让新的心搏数据得以添加和处理。”
由于 BeatDB 能够将心搏汇总为片段,医生可以更好地判断需要多少历史数据才能进行预测。“要提前 15 分钟预测血压下降,你可能需要数小时的患者数据,”O’Reilly 说。“由于 BeatDB 数据经过整理,并利用了机器学习算法,医生不必反复计算。他们可以试验需要多少数据和提前量,然后检查模型的准确性。”
最近,O’Reilly 开始运用这项技术探索心电图(ECG)数据。“我们希望研究可能在量化自我实践中收集的数据,”O’Reilly 说。她所指的是一种新兴做法:佩戴健身手环来追踪个人的身体数据。
“越来越多的人通过佩戴 Fitbit 等设备来监测自身,了解自己是否疲倦、睡得如何,”O’Reilly 说。“解读所有这些身体信号,与 GigaBEATS 项目类似。可以围绕这些信号建立类似 BeatDB 的数据库和云端平台,帮助解读它们。”
本文由 MIT News 合作发布。发表本文并不代表世界经济论坛认可其中观点。
了解论坛动态:Agenda 订阅我们的每周通讯。
作者:Eric Brown 是 MIT News 的特约撰稿人。
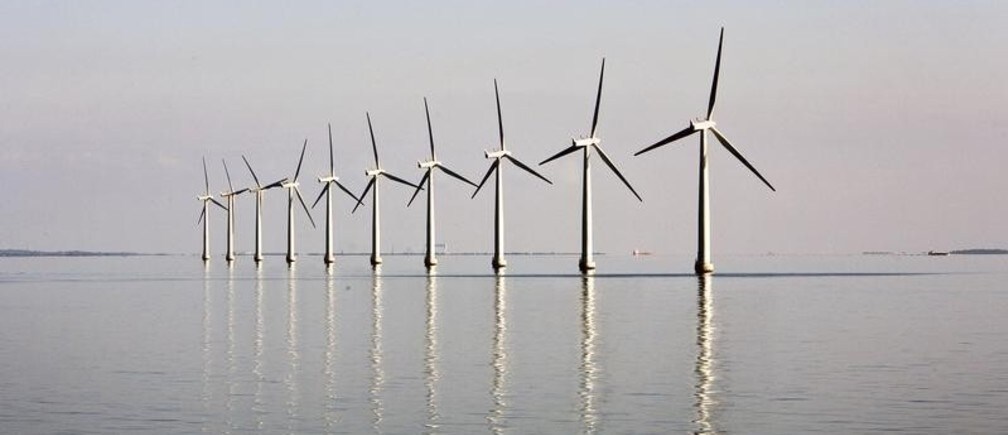
图片:2008 年 5 月 19 日,丹麦萨姆索岛附近的海面上,一座海上风电场矗立水中。路透社/Bob Strong。


