正确诊断癌症患者,并确定癌症的具体类型,对成功治疗患者至关重要。
如今,医生可能会参考十来个相似病例和一本厚厚的指南。但如果医生能把你的检测结果和病史输入一个计算机程序,而该程序已经分析了数百万条类似数据,那会怎样?
多亏麻省理工学院的研究人员,这样的未来正变得越来越有可能。 计算机科学与人工智能实验室 (CSAIL)的研究人员与马萨诸塞州总医院(MGH)的团队合作,博士生袁罗和麻省理工学院教授彼得·索洛维茨开发了一种计算模型,旨在通过学习数千份既往病理报告中的数据点,自动提出癌症诊断建议。这项研究已于本月 发表 在《美国医学信息学协会杂志》上。
更准确地诊断淋巴瘤
研究人员聚焦于淋巴瘤最常见的三种亚型。淋巴瘤是一种常见癌症,有50多种不同亚型,且往往难以区分。据MGH淋巴瘤中心主任、论文合著者之一埃弗雷姆·霍克伯格称,约有5%至15%的淋巴瘤病例最初会被误诊或错误分类。这可能造成严重问题,因为不同淋巴瘤所需的治疗方案差异很大。
例如,霍克伯格最近接诊的一位患者曾被误告知,她的淋巴瘤无法治愈。如果他没有准确诊断病情并为她制定积极的治疗方案,可能就为时已晚,无法遏制癌症。
长期以来,淋巴瘤分类一直是病理学家和临床医生争论的话题。2001年之前,至少存在五套不同的指南;当年,世界卫生组织(WHO)发布了共识分类。2008年,WHO通过一项耗时费力的流程修订指南,参与者包括一个由八人组成的指导委员会,以及全球130多位病理学家和血液学家。此外,为涵盖50种亚型,研究人员仅审阅了来自欧洲和北美的约1,400个病例;这意味着平均而言,每种亚型的诊断标准只依据有限人数的病例。
与此同时,MGH等大型医疗机构往往会存档数十年的病理报告。这让麻省理工学院的研究人员思考,能否利用这些资源开发自动化工具,帮助医生更好地理解如何诊断淋巴瘤。
论文第一作者袁罗说:“确保分类指南与时俱进,并根据大量患者病例准确归纳总结,这一点很重要。我们的工作梳理了详尽的病例,帮助医生更全面地把握淋巴瘤之间细微的区别。”
便于医生理解的模型
袁罗强调,这类机器学习模型不仅需要准确,也必须便于临床医生理解。WHO指南通过一组检测结果来列出判断标准,而这些检测结果本身又是肿瘤细胞、表面抗原等医学概念之间的关系。为捕捉这些关系,研究人员将病理报告中的句子转换为图表示:图节点代表医学概念,图边代表句法/语义依存关系。正如他们在 此前的论文中所述,随后他们收集了频繁出现的子图,这些子图对应于用于明确检测结果的关系。
袁罗说:“临床医生的诊断推理会同时依据多项检测结果。因此,我们有必要以一种与检测结果组相对应的方式,自动对这些子图进行分组。这样一来,临床医生就能理解这个模型,而不必把它当作黑箱;他们经常抱怨许多其他机器学习模型就像黑箱一样。”
这项工作的核心贡献,是采用一种名为子图增强非负张量分解(SANTF)的技术。在SANTF中,约800个病例的数据被整理成一个三维表格,其维度分别对应患者集合、常见子图集合,以及报告中每个数据元素被提及之处及其附近出现的词语集合。这种方法同时对每个维度进行聚类,并利用各维度中的关系来约束其他维度中的关系。通过考察由此形成的簇,研究人员可以将检测结果组与淋巴瘤亚型联系起来。
彼得·索洛维茨说:“如果应用于非常庞大的数据集,袁罗这项工作的潜力在于,由此帮助识别这些簇的标准能够让医生了解如何认识各种淋巴瘤,以及它们彼此之间的临床关系。”
犹他大学生物医学信息学系主任温迪·查普曼教授解释说:“临床报告中的大多数自然语言处理工作都侧重于识别重要短语或属性,而不是更难的识别关系和概念的任务。拥有多年经验的医学专家不仅能理解文字,还能理解更深层的含义。这项研究让我们离开发能够达到这种理解水平的稳健计算机模型又近了一步。”
此外,SANTF模型无需带标签的训练数据,因此可以实现知识发现流程自动化。索洛维茨相信,团队的模型能够帮助医生依据更全面的证据,更准确地诊断淋巴瘤,甚至可能被纳入未来的WHO指南。
索洛维茨说:“我们的最终目标是将这些技术用于极其庞大的淋巴瘤数据,规模达到数百万个病例。如果能做到这一点,并识别出不同亚型各自特有的特征,我们就能大大减轻医生的工作负担,也或许能延长患者的寿命。”
本文由 麻省理工学院新闻合作发布。本文的发布并不代表世界经济论坛认可其中的观点。
如需了解议程的最新动态, 请订阅我们的每周简报。
作者:亚当·康纳-西蒙斯是麻省理工学院新闻的特约撰稿人。
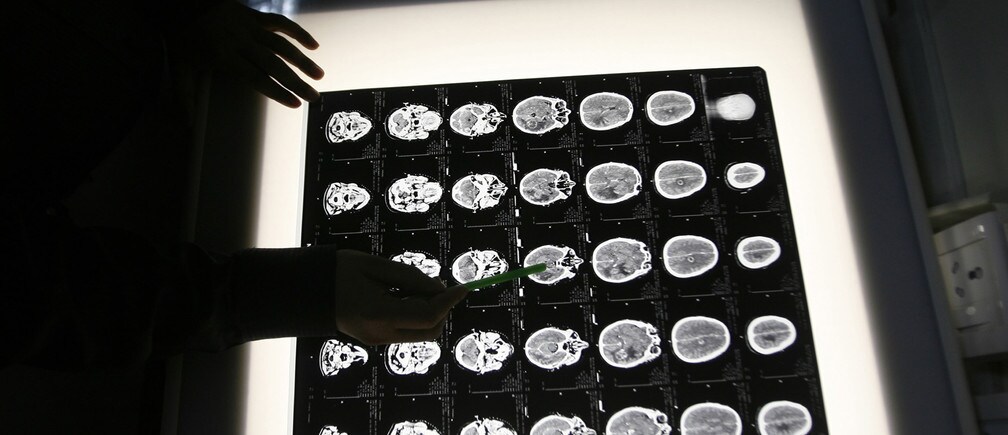
图片:一名放射科医生正在查看一位患者的脑部X光片。该患者在北孟加拉肿瘤中心接受了癌症预防体检。路透社/Rupak De Chowdhuri。