“机器能思考吗?”著名数学家、密码破译者和计算机科学家艾伦·图灵在近70年前提出了这一问题。如今,一些专家毫无疑问地认为,人工智能(AI)将很快能够很快能够发展出通用智能,即人类所具备的那种智能。但另一些人则认为,机器永远无法与人类相提并论。尽管人工智能已能在某些任务上超越人类,就像计算器一样,但它们无法被教会人类的创造力。
毕竟,我们的独创性有时由激情和直觉驱动,而非依靠逻辑和证据,这使我们得以取得令人瞩目的发现,从疫苗到基本粒子,范围十分广泛。难道人工智能就永远无法与之匹敌吗?事实或许并非如此。一篇近期发表于《自然》(Nature)的论文报告称,一种人工智能已能够仅通过从研究出版物中提取有意义的数据,来预测未来的科学发现。
语言与思维有着深刻的联系,它塑造了人类社会、人际关系,并最终塑造了智能。因此,人工智能研究的圣杯是全面理解人类语言的各种细微之处,这并不令人意外。自然语言处理(NLP)属于一个更大的范畴——机器学习,其目标是对文本数据进行评估、提取和分析信息。
儿童通过不断试错,与周围的世界互动来学习。学习骑自行车通常要经历几次摔倒和碰撞。换言之,我们会犯错,并从错误中学习。这正是机器学习的运作方式,有时还会加入一些额外的“教育性”输入(即监督式机器学习)。
例如,人工智能可以通过从大量个别示例中逐步建立物体图像,从而学会识别图像中的物体。在这一过程中,需要由人类向其展示包含或不包含该物体的图像。随后,计算机会判断图像中是否存在该物体,并根据人类对其判断准确性的评估来调整其统计模型。然而,我们也可以让计算机程序自行完成所有相关学习(即无监督式机器学习)。在这种情况下,人工智能会自动开始能够检测数据中的规律。无论哪种情况,计算机程序都需要通过评估自身错误的程度来寻找解决方案,并尝试加以调整,以将此类错误降至最低。
假设我们想要了解与某种特定材料相关的一些特性。显而易见的做法是从书籍、网页以及其他任何适当的资源中搜索信息。然而,这一过程十分耗时,可能需要花费数小时进行网络搜索、阅读文章和专业文献。不过,自然语言处理可以帮助我们。借助复杂的方法和技术,计算机程序能够从大型文本数据集中识别概念、相互关系、一般主题以及具体属性。
在这项新研究中,一种人工智能通过无监督学习,学会了从科学文献中检索信息。这具有显著的意义。迄今为止,大多数现有的基于自然语言处理的自动化方法都是有监督的,需要人工输入。尽管与纯人工方法相比已有所改进,但这仍然是一项劳动密集型工作。
然而,在这项新研究中,研究人员创建了一个能够独立、准确地识别和提取信息的系统。该系统运用了基于数据统计与几何特性的复杂技术,用以识别化学名称、概念和结构。该系统基于约150万篇有关材料科学的科学论文摘要。
随后,一个机器学习程序根据“元素”“能量学”和“粘合剂”等具体特征,对数据中的词语进行了分类。例如,“热”被归类为“能量学”的一部分,“气体”则被归类为“元素”。这有助于将某些化合物与磁性类型以及与其他材料的相似性等联系起来,从而在无需人工干预的情况下,揭示词语之间的关联方式。
科学发现
该方法能够捕捉复杂的关系,并识别不同层次的信息,而这些工作几乎不可能由人类完成。它提供的洞见远远早于科学家目前所能做出的预测。事实上,人工智能能够在材料实际被发现的数年前,就推荐其用于功能性应用。其中共有五项此类预测,均基于2009年以前发表的论文。例如,人工智能成功识别出一种名为CsAgGa2Se4的物质,将其视为一种热电材料,而科学家直到2012年才发现该物质。因此,如果人工智能在2009年就已存在,它本可以加快这一发现的进程。
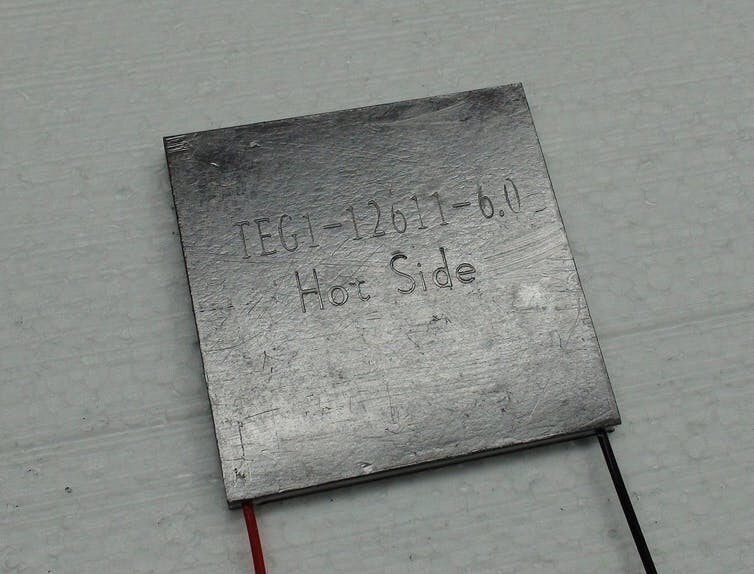
它通过将该化合物与“硫族化物”(含有“硫族元素”,如硫或硒的材料)、“光电子”(用于光源生成、探测和控制光的电子器件)以及“光伏应用”等词语相关联,从而做出预测。许多热电材料都具有此类特性,而人工智能很快便证实了这一点。
这表明,关于未来发现的潜在知识,在很大程度上已蕴含于过去的出版物之中。人工智能系统正变得越来越独立。而且,我们无需畏惧。它们能够极大地帮助我们在人类活动持续产生的海量数据与信息中进行导航。尽管人们对隐私和安全问题存有担忧,人工智能仍在改变我们的社会。我相信,它将引导我们做出更好的决策,改善我们的日常生活,并最终使我们变得更加睿智。




