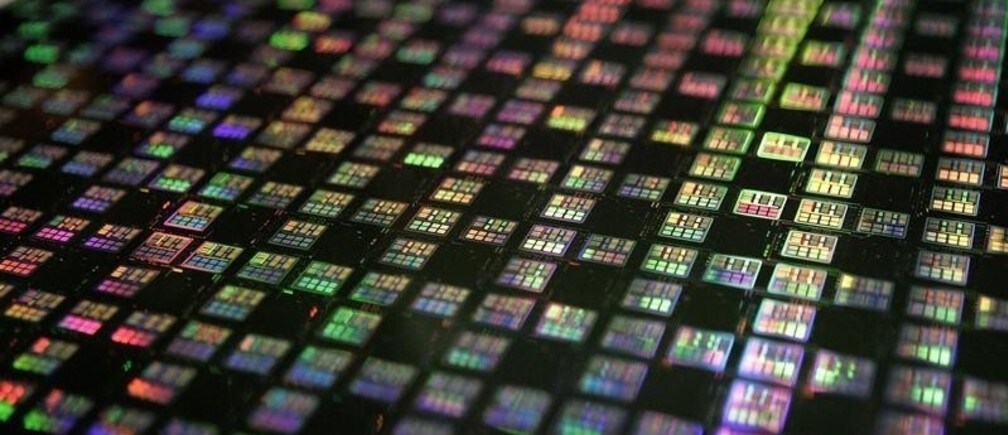
计算机芯片的时钟频率已不再继续提升。为了持续提高性能,芯片制造商转而为芯片增加处理单元,即核心,使其能够并行执行计算。
不过,芯片划分计算任务的方式会对性能产生重大影响。在一篇发表于2013年的论文中,麻省理工学院电气工程与计算机科学系 TIBCO 创始人助理教授 Daniel Sanchez 与他的学生 Nathan Beckmann 介绍了一种系统:该系统巧妙地在多核芯片的存储体之间分配数据,平均将执行时间缩短了18 percent,同时还提高了能效。
本月,在电气与电子工程师协会国际高性能计算机体系结构研讨会上,Sanchez 研究组的成员凭借对该系统的扩展入围最佳论文奖。扩展后的系统不仅控制数据的分配,也控制计算任务的分配。在涉及一款64核芯片的模拟中,该系统将计算速度提高了46 percent,同时将功耗降低了36 percent。
“如今,提高性能的途径是增加核心数量,并转向规模更大的并行系统;我们确实已经看到,关键瓶颈在于通信和内存访问,”Sanchez 说。“我们在之前的项目中所做的很大一部分工作,是让数据靠近计算。但我们发现,计算任务的放置方式,会显著影响你将数据放在附近的效果。”
解耦
同时分配计算任务和数据的问题,与芯片设计中的一个典型问题非常相似,这个问题称为“布局布线”。布局布线问题从一组逻辑电路的规格说明开始,目标是将这些电路安排在芯片上,使协同工作的电路元件之间的距离尽可能短。
这个问题属于所谓的 NP难问题;也就是说,据目前所知,即使对于规模适中的芯片,世界上所有计算机也无法在宇宙存续期间找到最优解。不过,芯片制造商已经开发出多种算法;这些算法虽然无法保证绝对最优,但在实践中似乎表现良好。
将这些算法用于在一款64核芯片上分配计算任务和数据,得出一个解需要数小时。Sanchez、Beckmann 和 Sanchez 研究组的另一名学生 Po-An Tsai 开发了他们自己的算法,找到的解,其效率超过标准布局布线算法所产生结果的99 percent。但该算法只需数毫秒。
“我们的做法是先大致安排数据的位置,”Sanchez 说。“以这样的方式分散数据,既不会让大量[内存]存储体负载过重,也不会让所有数据都集中在芯片的某个区域。然后,你再确定如何放置[计算]线程,使它们靠近数据;接着,根据线程的位置进一步调整数据的位置。通过这三个步骤来求解,就能把问题解耦。”
Beckmann 补充说,原则上,这个过程可以重复进行,再次分配计算任务以适应数据布局,反过来也一样。“但我们达到了1 percent,所以就停下来了,”他说。“归根结底就是这样。”
持续监测
麻省理工学院研究人员的系统会监测芯片的运行情况,并每隔25毫秒重新分配数据和线程。这听起来很快,但对计算机芯片来说,足以执行5000万次操作。
在这段时间内,监测器会随机抽取不同核心发送给内存的请求样本,并以简化形式将所请求的内存位置存储在自己的内存电路中。
芯片上的每个核心都有自己的缓存——一种本地高速存储体,用来存储频繁使用的数据。监测器根据采集的样本估算每个核心需要多少缓存空间,并跟踪哪些核心正在访问哪些数据。
监测器确实占用了芯片约1 percent的面积,而这部分面积原本可以用于额外的计算电路。但 Sanchez 认为,芯片制造商会认为,为显著提升性能而付出这点代价并不高。
“美国国家科学院曾开展一项大型研究,DARPA 资助的[信息科学与技术]研究也探讨了通信的重要性已超过计算这一问题,”威斯康星大学麦迪逊分校计算机科学教授 David Wood 说。“从其中一些研究可以看到,移动操作数以供计算所消耗的能量,比计算本身消耗的能量高一个数量级。有些情况下高两个数量级。这意味着,你需要避免这种做法。”
Wood 说,麻省理工学院研究人员“提出的方案似乎能应用于实际问题,并取得相当惊人的结果。这是一个重要问题,而这些结果看起来非常有希望。”
本文由 MIT News合作发布。本文的发布并不意味着世界经济论坛认可其中的观点。
如需及时了解议程动态,请 订阅我们的每周通讯。
作者:Larry Hardesty 是 MIT News 的撰稿人。
图片:2007年1月9日,台湾积体电路制造股份有限公司(台积电,TSMC)新竹厂区展示一片12英寸晶圆。路透社/Richard Chung。


