在这个数字互联的时代,我们每个人每天都会产生海量数据点。我们搜索什么,如何搜索;我们买什么、读什么;我们喜欢什么、不喜欢什么,选择与谁交往,此外还有许多其他信息——这些数据源源不断。将其量化、筛选,并与其他所有人的数据汇总分析,就能揭示此前隐藏的规律,有时甚至能发现我们自己都没有意识到的事情。
这些数据或许能让我们作为一个社会,更好地真正了解人们究竟是什么样的人。作家塞思·斯蒂芬斯-戴维多维茨在他的新书中提出了这一观点,供我们思考:《人人都在说谎:大数据、新数据,以及互联网能告诉我们关于真实自我的什么》斯蒂芬斯-戴维多维茨曾任谷歌数据科学家,目前也是沃顿商学院的客座讲师。他做客Sirius XM第111频道的《Knowledge@Wharton》节目,谈到经过恰当分析的大数据能揭示我们的政治观点、健康状况、偏见等信息。
以下是经过编辑的访谈记录。
Knowledge@Wharton:毫无疑问,我们的数字足迹能透露很多关于我们自己的信息,但我感觉,人们在某种程度上仍会对从这些信息中能挖掘出如此多内容的说法嗤之以鼻。
斯蒂芬斯-戴维多维茨:是的。有些人对数据有一种传统认识。他们把数据想成具有代表性的调查:问题明确,带有复选框,人们可以清楚作答。我觉得,互联网这个纷繁复杂的世界让他们有些不自在,因为这里的数据往往结构不那么规整,也与他们熟悉的形式有所不同。
Knowledge@Wharton:你觉得人们是否仍认为自己的数据安全程度高于实际情况?
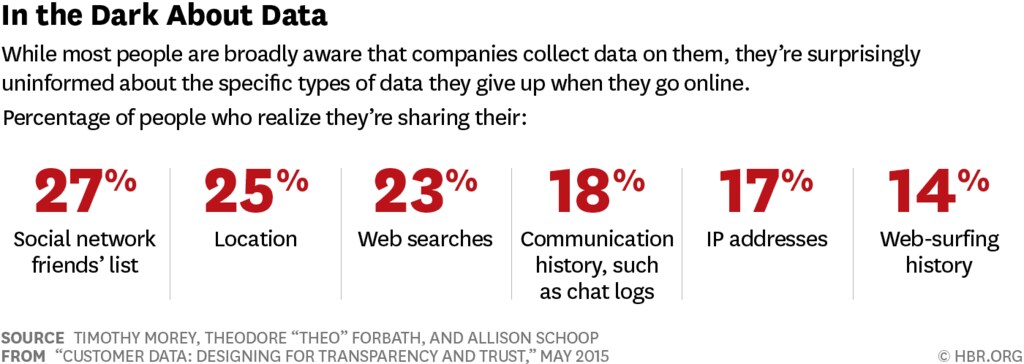
斯蒂芬斯-戴维多维茨:我认为,人们确实担心大数据的力量。数据的预测能力很强,公司可能会利用它来占人们的便宜。我在书中谈到了这一点。比如,申请贷款时,公司仅凭你在贷款申请中使用的词语,就能预测你是否会还款。举例来说,如果你在贷款申请中用了“上帝”这个词,违约的可能性会高出2.2倍,也就是不还款的可能性高出2.2倍。因此,公司不向那些在申请结尾写着“上帝保佑你”的人放贷,就可能省下钱。这确实挺令人害怕的。
Knowledge@Wharton:在书中,你探讨了社会面临的一些重大问题,比如种族主义和虐待儿童。在这些领域,各种数据点都可能指向不同的方向。
斯蒂芬斯-戴维多维茨:没错。如今网络上有海量信息。有些信息来源,像谷歌,就是我重点研究的对象。人们往往会非常坦诚地告诉谷歌一些他们可能不会告诉任何人的事情。因此,谈到你提到的那些重要领域时,我们能够对自己有全新的认识。
Knowledge@Wharton:你研究的领域之一是性。
斯蒂芬斯-戴维多维茨:我喜欢说,大数据的力量如此强大,竟让我成了性方面的专家,因为这原本并不是我的专长。显然,人们在性方面有很多谎言,因为这是个令人不自在、带有禁忌的话题。我认为,通过谷歌搜索,我们能更多地了解人们喜欢什么。
Knowledge@Wharton:你还研究了种族主义,并谈到种族主义并非在2008年总统竞选期间更突出,而是在奥巴马总统当选后立即显现得更加明显。
斯蒂芬斯-戴维多维茨:这些数据有令人不安的一面。一般来说,如果人们会撒谎让自己显得更好,那么我们对人性的看法就会过于乐观。但如果我们知道真相,遗憾的是,在许多领域,我们会看到人性更阴暗的一面,种族主义就是其中之一。这令人震惊。我从这些数据中很快发现,最令我意外的事情之一,就是人们进行种族主义搜索的数量惊人,他们基本上是在寻找嘲弄非裔美国人的笑话。没错,这是一个突出的主题——奥巴马一当选,人们就开始进行非常恶毒的相关搜索。
Knowledge@Wharton:长期以来,人们一直认为种族主义更多是南方的现象,但你的数据表明,情况未必如此。
斯蒂芬斯-戴维多维茨:是的。如果你通过调查提问,或依据大众的普遍看法,种族主义会被视为南方问题。但我认为,这或许是因为在南方,人们没那么需要掩饰种族主义。如果看更为坦诚的谷歌搜索数据,就会发现种族主义程度最高的许多地区都在北方:宾夕法尼亚州西部、俄亥俄州东部、纽约州北部以及密歇根州的工业区。如今种族主义的真正分界线不是南北,而是东西。
Knowledge@Wharton:如果个人或公司能以更系统、更有效的方式利用这些数据,你认为这总体上会对国家或社会产生什么影响?
斯蒂芬斯-戴维多维茨:我认为,未来有乐观和悲观两种情景。我不知道哪一种会成为现实。悲观的情景是,公司会利用这些数据占人们的便宜,让他们花掉自己并没有的钱,或者让他们在其实不必访问的网站上花更多时间。乐观的情景是,我们能够深入了解真正非常重要的领域——健康、种族主义、性——并真正学会如何改善社会。
Knowledge@Wharton:健康方面的应用非常有意思。我们或许能从数据中获得有助于治愈疾病的信息,采取更有效的预防措施,在疾病恶化前发现它们——这些都将对这个国家的人们产生巨大影响,也会对医疗保健相关经济产生重大影响。
斯蒂芬斯-戴维多维茨:是的。在我最喜欢的一项研究中,研究人员利用搜索数据找到了搜索过“刚被诊断出胰腺癌”之类内容的人。你知道,一个人这样搜索时,很可能刚刚被诊断出胰腺癌。然后,研究人员将这些人与从未被诊断出胰腺癌的相似人群进行比较,再查看前几个月里他们搜索过哪些症状。他们发现了一些非常细微的规律,这些规律可以预测一个人最终是否会被诊断出胰腺癌。
例如,如果你先搜索“消化不良”,接着搜索“腹痛”,这就是胰腺癌的一个风险因素。而只搜索“消化不良”则不是风险因素。这种规律极其细微,没有海量数据集就很难发现,几乎预示着一种新型医学的出现。
Knowledge@Wharton:你在书中写到,谷歌趋势可能是推动大数据发展、加深我们对其理解的因素之一。
斯蒂芬斯-戴维多维茨:是的,这很有意思。谷歌趋势可以显示不同词语在哪些地方被搜索、在哪些地方搜索频率更高,也能让你看到搜索情况随时间如何变化。它刚推出时,人们觉得它有点像个笑话。大家不把它视为学术资料来源;它可能只是谷歌一种有趣的公关工具。你可以随便看看,了解哪些时尚潮流或名人受欢迎。但我认为,我们越来越清楚地看到,这绝不是玩笑。正如我所说,这可能是有史以来关于人类心理收集到的最重要的数据集,也无疑是研究人员值得重点使用的重要工具。
Knowledge@Wharton:与此相对,许多发布时声称提供了数据的调查,其准确性未必像它们让人们相信的那样高。
斯蒂芬斯-戴维多维茨:是的,我认为调查存在很大的漏洞。我越研究调查,就越持怀疑态度,哪怕是很小的事情。最近,我查看了有关潜在购车行为的调查数据,并将其与实际购车情况进行比较,结果两者完全对不上。人们说自己要买车,最后却没有买;或者他们没说要买某辆车,最终却买了。所以我认为,调查的价值被严重高估了。未来,随着一些新的互联网数据来源变得更容易获取,调查的作用确实会小得多。
Knowledge@Wharton:这也是为什么更多公司开始认真研究分析方法和数据,以更真实地了解消费者在想什么,对吗?
斯蒂芬斯-戴维多维茨:是的。我还认为,关键是要谨慎。面对每一种数据来源,你都要想一想:这是什么数据来源?人们提供这些数据时有什么动机?我觉得,很多人只要看到数字或数据,就会说:“哦,这很可靠。”但许多数据来源都很糟糕——请原谅我的措辞。有些数据确实很不可靠,有些则可靠。但人们点击什么、购买什么、搜索什么,这些信息比许多其他你可能会考虑的数据来源更有价值。
Knowledge@Wharton:回到政治领域,你在书中谈到,数据以及互联网上的信息确实暗示特朗普总统将会胜出,不仅会赢得共和党初选,还会赢得大选,对吗?
斯蒂芬斯-戴维多维茨:我认为确实有一些线索。这有点难说。我最常被问到的问题之一就是:“你能用谷歌搜索来预测选举吗?”这有些困难,因为谷歌搜索数据出现以来,我们只经历了四次选举,所以要据此预测模型颇具挑战。
但我认为,四到八年内,我们就能利用这些数据非常准确地预测选举。我已经谈过一些我在选举前夕发现的线索,它们让我觉得特朗普将会获胜。有几个迹象提醒了我。第一,看看人们在选举前搜索的是“如何投票”还是“在哪里投票”,就能判断他们是否会实际去投票。你不能太相信人们在调查中说自己会投票。人人都说会去投票,但很多人最后并没有去。数据显示,非裔美国选民的投票率将远低于以往选举。这对希拉里·克林顿在选举中的表现造成了很大影响。
还有一个非常微妙、令我着迷的线索:人们搜索候选人的顺序可以透露他们会投给谁。如果人们搜索“特朗普/克林顿民调”,他们投票支持特朗普的可能性会高得多;如果搜索“克林顿/特朗普民调”,他们投票支持克林顿的可能性就高得多。而在中西部一些关键州,搜索“特朗普/克林顿民调”的次数要多得多。
Knowledge@Wharton:那么,仅仅是在搜索中出现克林顿这个名字,无论是否同时出现特朗普,是否也能得出什么结论?
斯蒂芬斯-戴维多维茨:不能,我认为仅凭这项搜索并不能说明什么,因为你可能是因为喜欢克林顿而搜索她,也可能是因为讨厌她而搜索她。你可能因为喜欢特朗普而搜索他,也可能因为讨厌他而搜索他。这并不能真正说明什么。需要更细微的线索。不过,搜索候选人的顺序确实具有预测力。甚至可能是人们在自己意识到之前就泄露了支持谁,因为人们可能觉得自己尚未决定,但如果他们一直搜索“特朗普/克林顿辩论”“特朗普/克林顿民调”“特朗普/克林顿选举”,他们很可能会支持特朗普。
Knowledge@Wharton:不过,你认为我们是否正在逐渐更全面地了解现有的各种数据?人们似乎经常说,我们其实并不真正理解这些数据。或许要逐步摸清许多数据的情况,还需要一些时间。
斯蒂芬斯-戴维多维茨:我认为我们进展很快。还需要更多人参与。我觉得,起初人们认为仅凭互联网行为就能了解一个人,这个想法太奇怪,因此这一领域得到的学术研究远不如应有的程度。但如今相关研究越来越多,这一领域的方法学研究者也越来越多。我们确实正在取得进展。如今,数据带来的不再只是“这很酷”这样的感受,我们已经从中真正获得了关于自身的深刻洞见。
Knowledge@Wharton:那么,这会成为美国经济的一个增长领域吗?那些懂得分析、知道如何利用这些数据来真正影响公司和个人的人,会越来越多吗?
斯蒂芬斯-戴维多维茨:绝对会。但我认为,这比人们意识到的更微妙。在我沃顿商学院的课堂上,这个问题经常被提起。一想到“大数据”,人们就觉得这是非常技术性的东西,全是统计学,是左脑主导的书呆子式研究。它确实是一个技术领域——我不会否认这一点。但令人惊讶的是,它在很大程度上也是一个创造性过程。关键在于知道该问什么问题,以及如何从数据中找到有价值的信息。这不一定能教会。它有点像一门艺术,需要随着时间学习并精进。所以,我认为这并不是把一个数据科学家派去处理问题就能解决的那么简单,事情要复杂得多。
Knowledge@Wharton:这让我觉得,未来几十年,我们会看到数据科学家与各类商业领域建立更多合作,努力摸清如何利用数据应对世界上一些最严峻的问题,无论是水资源获取还是抗击疾病。
斯蒂芬斯-戴维多维茨:这令人振奋——可能性确实令人惊叹,而且涉及许多重大领域。既然这种新数据已经存在,而且更为坦诚,我们就应该着眼于重大问题,大胆追求宏大的目标。拥有大数据,却去研究小问题,毫无意义。
Knowledge@Wharton:那么,人们能否借此更多地了解自己?我们经常谈到这些数据如何影响他人和企业:未来,人们能更好地了解自己吗?
斯蒂芬斯-戴维多维茨:我认为可以。数据常常比我们自己更了解我们。比如,Netflix在公司发展初期曾问人们:“接下来几天你打算看什么视频?我们知道你现在在看什么,但这个周末你想看什么?这样周末到了我们就能提前为你排好。”人们回答时会说“我要看纪录片”,或者“我要看法国先锋派电影”。到了周五,片单已经排好,他们却视而不见,转而观看一直以来看的那些低俗喜剧或爱情片。Netflix后来意识到,他们应该忽略人们说的话,转而关注人们实际做的事,让算法来揭示真相。
我们往往会对自己未来会做什么作出糟糕的预测。几乎所有人都过于乐观。我认为,数据能更好地让我们认清现实。
Knowledge@Wharton:这也能帮助我们更清楚地了解这个国家与中国、法国或德国等国相比可能有哪些不同。从全球视角思考时,无论是在商业、政治还是其他许多方面,这都会产生影响。
斯蒂芬斯-戴维多维茨:当然。能够通过这些数据揭示各国之间的差异,确实很有意思。当然,从商业角度来看,有些国家的数据简直糟糕透顶。我认为尼日利亚是非洲最大的经济体;有一次,人们发现其GDP估算存在缺陷,竟在一夜之间将估值调整了90%。因此,有些国家的传统数据质量实在太差。如今出现的一些新数据来源,能够大幅提升我们对这些国家的了解。
我谈到了夜间灯光数据,它可以根据产生的光量来衡量经济。我还谈到了Premise,这家公司基本上会在发展中国家四处拍摄经济活动,然后根据这些照片估算通胀率、利率等许多指标。
Knowledge@Wharton:这些不同因素带来的变化潜力巨大。它们似乎能提供更好的预测工具,帮助世界各地的经济体促进增长或避免陷阱。
斯蒂芬斯-戴维多维茨:是的。我认为自己是个非常愤世嫉俗、持怀疑态度的人,所以听到“大数据”这样的术语或流行词时,我常常会想:“唉,这些东西真傻,不过是最新、最热门的一阵风潮。”但我研究这个领域已经五年了,也和业内人士谈过。我不断被它能揭示的内容震撼。这不是一时风潮,而是一场真正的革命,将改变我们对人和世界的认识。
Knowledge@Wharton:你自称愤世嫉俗,但你的生活围绕着数据。数据确实是真相,对吗?
斯蒂芬斯-戴维多维茨:是的。从某种意义上说,这印证了我的怀疑和愤世嫉俗:你不能相信人们告诉你的话。许多传统数据来源都受到提供数据者动机的影响。但如果你知道该看哪些数据,我对能够从中学到什么一点也不悲观。
Knowledge@Wharton:如今,你每天都沉浸在这些数据中。我的意思是,这个领域目前没有明确边界,凡是你可能想要影响的事情,几乎都有相关数据。这可能意味着,你可以逐个走访企业,每天收集数据,对吗?
斯蒂芬斯-戴维多维茨:是的。我在沃顿商学院课程结束时安排了一次小组展示,给学生的主题范围非常宽泛。我只是说:“想一个教育领域的新业务,或者想一个健康领域的新业务,再想一个政治领域的新业务;想想如何运用新数据和大数据工具来帮助这些业务。”每次展示结束时,所有学生都会说:“为什么这种东西还不存在?这说不通啊,它本来就应该存在。”通常,提出新想法很难,因为聪明人穷尽一生寻找应该存在、也是人们想要的东西。但我认为,借助大数据,在一个重大领域提出一个重要的新想法,出奇地容易。
Knowledge@Wharton:那么,你对未来持乐观态度吗?你正在与下一代共事,也就是将来会进入社会的学生。他们了解这些数据点的重要性,也会继续推动其发展壮大。
斯蒂芬斯-戴维多维茨:这确实令人兴奋。我唯一担心的肯定是伦理问题。企业可能会变得过于强大,甚至能够榨取消费者身上的每一分钱,因为它们比消费者本人更了解消费者。这确实是我非常担心的事情。
Knowledge@Wharton:你如何防范这种情况?
斯蒂芬斯-戴维多维茨:这需要付出大量努力。我认为,法律和伦理领域的大多数人还没有充分准备好应对大数据在其中一些领域带来的革命性变化。基本上,我喜欢这样理解:一切都与一切相关。几乎没有什么事物的相关性为 0.000。因此,你做的几乎任何事情都能预测你会做的其他事情。传统上,公司只能依据三四五个变量进行预测。但现在,它们几乎可以利用任何人曾经做过的一切来进行预测。这种技术的力量非常强大。




