过去几年,深度学习几乎彻底改变了它所应用的每个领域,带来了计算机科学史上最大的性能飞跃。
对于许多问题,我们过去每年只能看到微小、渐进的改进;如今,得益于深度学习的应用,我们见证了在数月内实现20% – 30%的提升。
这项成功也引发了媒体和公关领域的大量热议,因此如今“人工智能”“机器学习”和“深度学习”等术语被广泛使用,但往往用得不准确,令人困惑。
我们有必要尝试厘清并揭开这些技术术语之间的区别,然后聚焦于它们在网络安全领域的应用。
人工智能
人工智能(AI)这一说法由先驱计算机科学家约翰·麦卡锡于20世纪50年代提出,是一个总称,涵盖所有能够使机器展现任何形式智能的方法和学科。
其范围从20世纪80年代的专家系统(基本上是经过硬编码的知识数据集),一直延伸到2010年代最先进的人工智能形式。
如今,几乎所有行业的软件都至少采用某种形式的人工智能,即使仅限于一些手动编码的基本流程。
机器学习
机器学习目前是人工智能领域的主要分支。它使计算机能够在未被明确编程的情况下进行学习。
基于机器学习的方法在21世纪初全面主导了人工智能,其表现超过了所有非机器学习方法的成果。
尽管取得了成功,传统机器学习的一大主要局限在于依赖特征提取:这一过程由人类专家指定每个问题的重要特征(即属性)。
例如,将机器学习应用于人脸识别时,不能把图像中的原始像素直接输入机器学习模块,而必须先将其转换为特征,例如瞳孔间距、面部比例、纹理、颜色等。
这一特征提取阶段实际上会导致大部分原始数据被忽略;无论选取的特征多么出色,都无法捕捉数据中丰富的非线性关系。
深度学习
深度学习(又称“深度神经网络”)是机器学习的一个分支,其灵感来自我们大脑的运作方式。
深度学习与传统机器学习在概念上的重大区别在于,深度学习是第一个、也是目前唯一一种能够直接使用原始数据进行训练的学习方法(例如我们在人脸识别示例中提到的像素),无需进行任何特征提取。
此外,深度学习能够很好地扩展至数亿个训练样本,并且随着训练数据集不断扩大而持续改进。
令人难以置信的成功
过去几年,深度学习在计算机视觉、语音识别和文本理解的大多数基准测试中实现了20-30%的提升,创造了人工智能和计算机科学史上最大的性能飞跃。
两大关键因素促成了深度学习突如其来的惊人成功。
首先是算法的改进。几年前,我们还只能训练浅层神经网络;受算法局限影响,更深的网络无法收敛。
如今,改进后的训练方法可以成功训练非常深的神经网络,其包含数十层和数十亿个突触(神经元之间的连接)。
第二个也是更重要的因素,是图形处理器(GPU)的使用。
如今,所有深度学习训练都在英伟达的GPU上进行,速度比其他硬件快100倍(相比之下,一个在CPU上需要三个多月训练的深度学习大脑,使用GPU大约一天即可完成训练)。
尽管深度学习在许多任务中取得了成功,进入深度学习领域的门槛仍然很高,主要原因是深度学习研究人员和科学家十分稀缺,而他们对其成功应用至关重要。
人工智能与网络安全
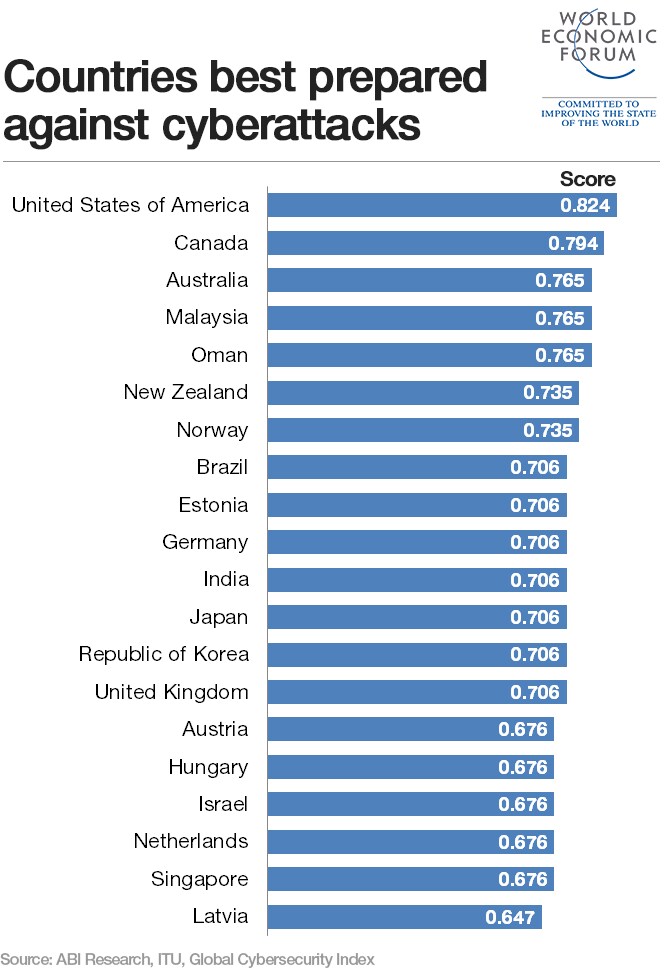
每天都会出现超过一百万种新的恶意软件,而且这些恶意软件的复杂程度持续提高,因此检测任务仍然十分困难。
传统的基于特征码的解决方案只能检测目前已知的恶意软件,而任何广为人知的恶意软件都可以轻易变异,从而逃避这些方案的检测。为了应对这一日益严峻的难题,如今许多网络安全解决方案都采用某种形式的人工智能。
基于启发式的方法在这一领域只能带来有限的改进,因此,最先进的网络安全解决方案转而采用机器学习。
借助机器学习,可以用大量文件数据集进行训练,使系统自动学会区分恶意文件与合法文件,这是任何手动或半手动方法都无法做到的。
逃避检测
尽管机器学习显著提升了网络安全能力,复杂的恶意软件仍能相对轻易地逃避检测。
应用传统机器学习时,必须先将计算机文件从原始字节转换为特征列表(例如重要的API调用等),然后才能把这个特征列表输入机器学习模块。
即使人类专家考虑了数百或数千种特征,它们仍只代表文件原始数据的一小部分;因此,文件很容易通过变异来逃避这些线性高层特征的检测。
与深度学习在其他领域的应用类似,将其应用于网络安全可以直接处理文件内容,无需进行特征提取。
也就是说,深度学习大脑的输入是原始字节值,无论文件格式、文件大小,甚至操作系统为何。
持续改进
此外,与传统机器学习随着训练文件数量增加而达到性能上限不同,深度学习能够随着数据集扩大而有效提升,数据集规模可达数亿个恶意和合法文件。
比较深度学习与传统机器学习在网络安全领域表现的基准测试结果显示,深度学习的检测率显著更高,误报率则更低。
这些结果与深度学习应用于其他领域所带来的显著性能提升相一致。
随着恶意软件开发者采用更先进的方法制造新型恶意软件,深度学习与传统机器学习的检测率差距将进一步扩大;未来几年,依靠深度学习将至关重要,只有这样才有现实的机会挫败最复杂的攻击。
如需了解更多有关2017届技术先锋的信息,请访问我们的网站。




