近年来,网络安全工程师逐渐转向一种名为“零信任”的新安全模型:其理念是,不应默认自动信任任何用户或设备。
数字社会尚未采用这种做法。网络用户往往跳过信息核验环节,全球虚假和误导性信息不断增多便是明证。
借鉴零信任模型的原则,网络用户可以结合新兴人工智能技术、人类审核和区块链技术的力量,更好地核验信息。
信任,还是不信任? 近年来,错误信息、虚假信息和假新闻激增这表明,这个莎士比亚式的问题实际上并非关键;该问的也不是该信任谁。
人们往往依赖那些他们认为权威的信息来源,而这些来源实际上是否可信并不重要——它可能是社交媒体或电视上的内容,甚至是大型语言模型(LLM)网站对提示词的回答。当信息泛滥却未必可靠时,网络用户真正应该寻求的答案是:我们应该如何信任。
这种信任挑战并不局限于任何媒介或地区,但技术在其发展过程中所起的作用不容忽视。技术进步使平台能够大规模传播信息,也能大规模传播错误信息。社交媒体算法在不总是核实事实的情况下推动用户互动;大型语言模型生成的文本可能将事实与幻觉无缝混杂;即便是历来享有声誉的新闻来源,也难以在相互竞争的说法泛滥时维持权威性。
然而,如果借鉴零信任的一项原则,技术领域或许也能找到应对这场信任危机的潜在方案。在网络安全领域,零信任意味着默认不信任任何用户、设备或交易;相反,每项请求都须经过身份验证并持续核验。
零信任的核心原则与网络用户通常消费数字信息的方式形成鲜明对比。如今,人们常常依赖平台被认为具有的权威性或熟悉感,完全跳过信息核验环节。然而,随着内容数量不断增加,维持标准变得越来越困难。
当前的网络安全举措够用吗?
一些平台已经意识到信任度正在下降,并试图通过社区驱动的核验工具重建可信度。例如,社交平台Twitter(现为 X)推出了一项由社区推动的内容审核计划,于2021年称为“Birdwatch”,后来更名为“Community Notes”。
这一做法邀请用户共同为可能包含误导性信息的帖子添加注释。从理论上看,这种去中心化的事实核查模式颇具前景:大众可以补充背景信息并指出不准确之处。然而,社区注释一直难以在实践中成为一劳永逸的解决方案。谁参与了注释、特定注释如何获得优先展示,相关透明度都有限。
集体审核的另一个例子是维基百科的开放编辑模式,志愿贡献者会评估并完善文章,以确保其准确性。维基百科表明,协作式审核有助于维持一定的质量基线:明显错误的信息往往很快得到纠正,平台也制定了严格的规则、引文要求和编辑讨论机制。但维基百科也无法免于各种挑战,包括编辑社群内部的骚扰,以及对诠释、来源和编辑偏见的分歧。该网站依赖志愿者,也意味着冷门主题得到的关注或专业知识支持可能不及热门主题。
这两个典型例子表明,尽管此类措施能在一定程度上发挥作用,却往往缺乏可扩展性和透明度。如果零信任框架已成为解决网络安全问题的有效方案,我们能否将类似理念应用于数字信息和信任?

变革蓝图
受到零信任模型的启发,我们可以设想建立一个公正、独立且完善的知识库,其中包含经过验证的真实来源、事实和信息,并将其作为标准化系统,应用于处理信息的平台——从新闻媒体到社交媒体平台。
这样的知识库可以整合三项要素,发挥各自优势:人工审核、区块链技术和人工智能驱动的分析。每项要素都将构成额外的核验环节,降低错误信息漏网的可能性,并提升数字话语的整体质量。
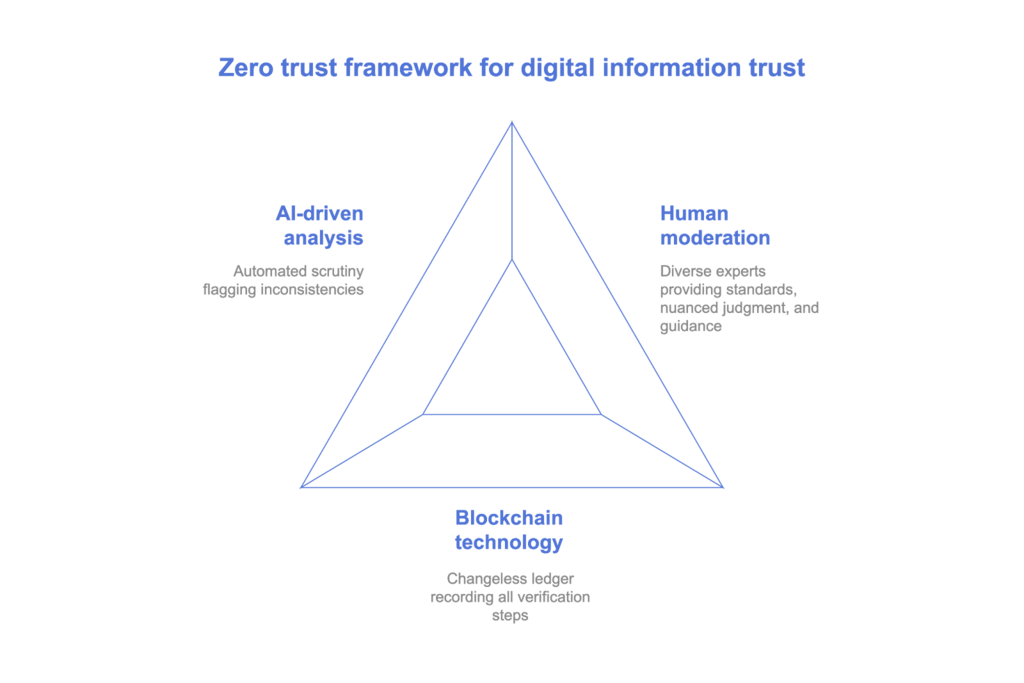
人工审核最好由一个透明且多元化的专家团队开展,可以提供细致入微的判断,审查关键事实主张,并就标准制定提供指导。他们不会评判每一条内容——这项任务正变得越来越不可能完成——而是帮助制定规则和界限。
直到近几年,区块链技术才开始摆脱与加密货币的关联。随着网络用户对区块链技术越来越熟悉,它可以充当不可篡改的账本,记录每条信息经历的核验步骤。在这一系统中,任何主张的事实核查历史、来源和编辑决定都将以去中心化的方式存储。用户和平台都可以追溯主张的来龙去脉,了解它何时、由谁以及依据哪些标准得到核验。
与这些要素相配合,人工智能和机器学习模型将承担分析和自动审查的工作。利用经审查的来源数据和已获认可的事实陈述进行训练后,这些模型可以标记不一致之处、指出可疑模式,甚至推荐质量更高的来源。透明的核验历史还能增加一层审查。尽管这些工具并非万无一失,但它们可以过滤大量可疑内容,减轻人工审核人员的负担。
这种理论模型只是前进的一种方式。平台还可以实施匿名身份验证,以证明信息分享者是真实用户而非机器人,从而帮助减少错误信息的自动化传播。网络分析可以帮助判断错误信息源自何处,以及它通常沿着哪些路径传播。找到错误信息的源头,对于控制其传播至关重要。
我们可以建立在每个环节都要求并展示可信度的系统,而不是把错误信息视为互联互通不可避免的副产品。拥抱这一转变,我们就能更接近这样的未来:事实与信任建立在更加坚实的基础之上。