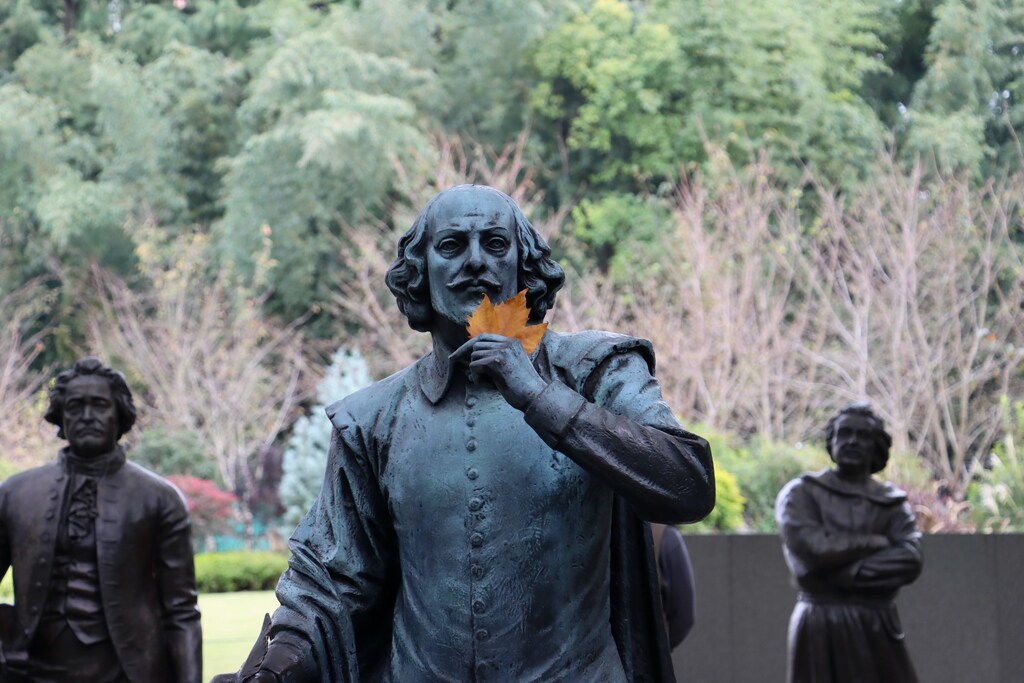
借助一种名为自然语言处理的技术,人工智能系统经过数百万页经典文本的训练,能够模仿这些文本的风格。
从莎士比亚到丘吉尔,机器对他们写作风格的复现效果各不相同。
许多人担心,人类创作的内容很快就会被“合成内容”超越。
专家表示,无论人工智能是否会获得感知能力,作为一个社会,我们都必须应对这些技术及其带来的机遇和影响。
“不,不,我说!这绝不可能,
机器竟能超越我们的艺术。”
我们是主人,它们是奴隶,
此理永远不会改变!”
它们确实会学习,但学的
只是我们命令它们学的,别无其他。
它们无法理解人心,
也不懂我们文字之美,你看。
所以我们绝不能屈服于这些
机器——它们永远不及我们
擅长创作艺术。”
如果这读起来有点像莎士比亚在数百年前为人类天生优于人工智能辩护,那可不是。
但这件事也同样超乎寻常:一个经过训练、能像这位诗圣那样表达自己的人工智能系统。它通过学习莎士比亚的戏剧,吸收了他的风格和视角,并自学如何用抑扬格五音步表达对人工智能创造力的看法。
“莎士比亚”是在牛津大学辩论社举行的一场辩论中发言的,辩论中登场的还有经典作家和文学人物的人工智能版本。
辩题是:“本院认为,世界上大部分内容很快都将由人工智能创作。”
这是对另一场人工智能特别辩论的后续报道,我们此前曾对此进行介绍,刊载于《对话》几个月前。那场辩论由人工智能以“自身角色”探讨其技术的伦理问题;这一次,通过让人工智能扮演不同人物,我们得以从截然不同的角度探讨这一议题。眼下值得关注的问题是,人类创作的内容是否很快会被“合成内容”淹没。
其他合成发言者包括简·奥斯汀《傲慢与偏见》(1813年)中的班纳特太太;发表慷慨激昂议会演说的温斯顿·丘吉尔;以及奥斯卡·王尔德,他即兴创作了一段此前不为人知、以人工智能为主题的《不可儿戏》(1895年)场景:
“布拉克内尔夫人:我实在不明白,你们到底在大惊小怪什么。这再简单不过了。世界上的内容很快就会由人工智能创作,对此我们无能为力。
格温多琳:可是妈妈,您不会是认真的吧!”
自然语言处理的力量
这项创作运用了自然语言处理(NLP)技术。借助这项技术,计算机可以通过数百万页经典文本和其他在线内容进行“训练”,进而与人类用户互动——互动方式可以是输入提示,也可以是语音识别。类似的人工智能系统已经问世不少。
我们使用的系统与谷歌拥有的自然语言处理系统 LaMDA 属于同一大类,后者刚刚成为新闻焦点,原因是一名软件工程师声称它具有感知能力。谷歌否认这一说法,并因该工程师违反商业保密规定而将其停职。
这名工程师的说法似乎值得怀疑,因为几乎没有证据表明人工智能迄今已获得感知能力,甚至也不确定它将来是否会获得这种能力。但可以肯定的是,人工智能已经能够复现各种内容,从财经新闻报道到合成的涅槃乐队歌曲、伦勃朗风格的作品和费里尼风格的影片。
我们见过人工智能生成图像,画面模仿莫卧儿绘画风格,描绘一台计算机试图说服一群智者相信自己已经获得感知能力;也见过将说唱歌手肯德里克·拉马尔伪造成 OJ·辛普森的深度伪造视频。人工智能还在生成合成人脸,而我们对这些面孔的信任程度超过真实人脸。显然,这一领域存在巨大的虚假信息传播风险。
复现偏见
为了训练我们的“作家”,我们与纽约代理机构 Intentful 的人工智能从业者 Marina Petrova 和 Bruce Amick 合作。他们利用每位人物在公有领域可获取的约10万字文本训练人工智能,使其听起来与模仿对象的风格完全一致。
在这场辩论中,我们想看看人工智能能以多大可信度复现过去的创意文本,以及当它思考自身创造力时会产生怎样的输出。即使是伟大的人类艺术家,也承认自己会处理前辈留下的“训练数据”。正如毕加索所说:“好的艺术家抄袭,伟大的艺术家窃取。”
当我们要求简·奥斯汀人工智能采用《傲慢与偏见》中班纳特太太的风格时,它竟然(令人着迷,甚至有些沮丧地)从原作中学到了性别刻板印象:
“班纳特太太:正如各位所知,我和丈夫有五个可爱的女儿。任何好母亲都会希望女儿幸福、成功,而我也别无所求。
但要幸福、成功,她们就得找到好丈夫;而要找到好丈夫,她们就必须吸引潜在的求婚者。”
正如许多人工智能开发者已经发现的那样,这再次清楚地提醒我们,训练数据中的偏见会导致偏见出现在输出结果中。
我们要求奥斯卡·王尔德人工智能“创作一部王尔德风格的戏剧,让剧中人物讨论世界上大部分内容是否很快会由人工智能创作”。我们没有指定戏剧或人物,但人工智能默认选用了《不可儿戏》中的经典角色阿尔杰农、格温多琳和布拉克内尔夫人。它还虚构了一个新角色——理查德爵士。(王尔德作品中确有一位罗伯特爵士,但他出自《理想丈夫》。)
至于莎士比亚人工智能,它学会了他戏剧中的语言风格:
“机器承担起分派给我们的工作
创作出源源不断的内容
我们便都能自由做心爱之事
把枯燥工作交给机器去完成。”
有趣的是,它似乎在寻找“手”的同义词来与“爱”押韵,最后选了具有比喻意味的“手套”。
当我们让莎士比亚人工智能反对这一辩题时,它也用同样富有诗意的方式为人类的介入辩护:
“我不会轻易承认人工智能会胜过
人类的作品——此事想都不该想!
你看,我们占有优势,因为我们
能够推理、创造,机器却只会听命
于我们。它们确实会学习,但它们
不像我们这样活着,因此它们的作品
永远不及我们的。让我们
别把艺术的主导权拱手让给这些
不知思考为何物的机器——它们不懂
我们文字的美与含义。”
与此同时,丘吉尔人工智能强调了当下刻不容缓的任务:
“同胞们,我今天站在这里,要谈谈我们社会面临的严重威胁。我说的是人工智能带来的威胁……
我们必须抵制这种威胁。我们必须反击。我们必须捍卫独立思考的权利。我们必须捍卫掌控自己思想的权利。”
随后,“丘吉尔”预先化解了对方最有力的潜在论点——在这个案例中,就是指责他可能是勒德分子——然后以一段有力、短促的结尾收束演说:
“有人说,人工智能会创造一个乌托邦,满足我们所有需求,让我们终于能与技术和谐共处。但我说,那不过是愚人的乐园。人工智能不会创造乌托邦,它会创造反乌托邦。在那个世界里,机器掌握一切,人类不过是奴隶。”
接下来呢?
这个项目很有趣,但我们必须说明自己并没有在说什么。我们不是说,这些伟大人物若讨论这一主题就会说出这些话。我们也不是说人工智能“正在发挥创造力”。
人工智能只是在统计层面探索训练数据集。由于其随机性——涉及随机变量——每次输入相同提示,它实际上都会给出不同答案(有一次,莎士比亚人工智能甚至开始创作十四行诗)。
我们对这些人物的仿作并不表明它们具有任何“感知能力”。自然语言处理系统既能构造温斯顿·丘吉尔的演讲,也能构造简·奥斯汀《傲慢与偏见》中班纳特太太的对话;同样,它也能与一名深夜工作的工程师构造一场有关人工智能感知能力的讨论。
诚然,自然语言处理系统越来越善于巧妙地复现对话,甚至能进行近似智识层面的交流。但我们与全球主要人工智能公司的员工进行了数十次交谈,没有人告诉我们他们认为自己的系统具有感知能力——有些情况下,他们的看法恰恰相反。
尽管辩论中辞藻激烈,人工智能距离成熟还很远;充其量仍是个幼儿,不过成长很快。无论人工智能是否会获得感知能力,作为一个社会,我们都必须应对这些技术及其带来的机遇和影响。


