本文字稿由语音识别软件生成,可能包含错误。请对照音频核实其准确性。
Mustafa Suleyman,Inflection AI联合创始人兼首席执行官:这将是我们有生之年最具变革性的时刻,不仅在科技领域,在文化和政治领域也是如此。
Robin Pomeroy,Radio Davos主持人:欢迎收听Radio Davos,这是世界经济论坛推出的播客,聚焦于最重大的挑战以及我们如何应对这些挑战。本周,三位人工智能先驱将探讨这项技术接下来将把我们带向何方。
Yann LeCun,Meta首席人工智能科学家:那些系统将能够理解物理世界,而当前的系统做不到这一点。它们将能够记忆,而当前的系统同样做不到。它们还将能够推理和规划,这也是当前系统所不具备的。我们将拥有比现在聪明得多的系统,其影响范围广泛,后果很难预测。
Robin Pomeroy:这位人工智能先驱描述了实现技术真正突破时,获得“尤里卡时刻”的感受。
Aidan Gomez,Cohere联合创始人兼首席执行官:它第一次能够真正使用语言,而在此之前没有任何东西能做到这一点。那就是我的“尤里卡时刻”。
Robin Pomeroy:这些站在前沿的专家可以帮助我们其他人理解生成式人工智能究竟是什么。
Aidan Gomez:我觉得这很难解释。其中有很多环节违反直觉,比如它的构造方式竟然如此简单。
Robin Pomeroy:他们还向我们讲述了他们的希望与担忧。
Mustafa Suleyman:回顾历史,每一项改变世界的通用技术都有一个非常一致的特征:只要它变得有用,就会变得更便宜、更容易使用,并且会广泛传播,惠及每一个人,无论是“好”的用途还是所谓“坏”的用途。
Robin Pomeroy:无论您通过何种渠道收听播客,都可以订阅Radio Davos,或访问wef.ch/podcasts,您还将在那里找到我们的姊妹节目Meet the Leader和Agenda Dialogues。
我是世界经济论坛的Robin Pomeroy,接下来将与三位人工智能先驱一同……
Yann LeCun:这或许会是人类的一次新文艺复兴。
Robin Pomeroy:这里是Radio Davos。
Aidan Gomez在二十岁时便与人合著了一篇研究论文,提出了一种名为Transformer的新型神经网络技术,它能够学习长串数据之间的关系。
Transformer正是ChatGPT中的“T”,ChatGPT的全称为Generative Pre-trained Transformer,即生成式预训练Transformer。
Mustafa Suleyman联合创立了DeepMind,这是一家后被谷歌收购的人工智能公司。他还撰写了畅销书《即将到来的浪潮》(The Coming Wave),探讨了人工智能与生物工程将如何塑造人类的未来。
Yann LeCun是Meta的首席人工智能科学家,同时也是纽约大学的教授。他是被称为“人工智能教父”的少数几位人物之一。
这三位人士均入选《时代》杂志评出的“全球人工智能百大最具影响力人物”,他们都出席了今年的达沃斯年会,是众多人工智能领军人物中的一部分。在本期节目中,他们将向我们讲述人工智能的过去、现在和未来。
让我们从Aidan Gomez开始。
Aidan Gomez:我是Aidan Gomez。我是Cohere的联合创始人之一,我们为企业构建大型语言模型。
Robin Pomeroy:您一定遇到过许多完全不了解生成式人工智能如何运作的人。您是否有一套固定的电梯演讲,用来解释它的工作原理?还是说这根本不可能做到?
Aidan Gomez:我觉得很难解释。其中有很多环节违反直觉,比如它的构造竟然如此简单。
基本上,你要收集海量数据,我们说的是来自互联网上数十亿个网页的数据,然后训练模型去重写这些数据,或者预测句子中的下一个词。仅仅通过完成这项简单的任务,模型最终就能学会做出令人惊叹的事情,比如推理、翻译和编写代码。所有这些数据都存在于网络之上。因此,只要用这些数据进行训练,让模型重新生成这些数据,并学习创造它们,它就能够学会完成非常复杂的任务。
Robin Pomeroy:您在涉足这一领域时,有没有过“尤里卡时刻”?是否有某个特定时刻,让您觉得:没错,我真的找到了什么?
Aidan Gomez:对我而言,过去大概八年来,一直是一系列的“尤里卡时刻”,并没有哪一个特别的时刻。
第一次时刻或许出现在深度学习和神经网络取得成功之际。这种架构受到大脑的启发,借鉴了我们已知在头脑中行之有效的机制。那大概是我第一次感到受到鼓舞,并觉得我们正走在通往某个目标的关键道路上。
Robin Pomeroy:您怎么知道它在起作用?想想电视的发明,人们第一次能够从远处让画面出现在屏幕上。你向这个神经网络输入一些东西,然后得到一些输出。是什么让你在另一端看到结果时,心想:哦,这确实有效?
Aidan Gomez:嗯,我认为,在早期,它远比我们今天的技术简单得多。当时做的是分类,也就是能够查看一张图片,知道图片里有什么,并告诉你。
在某个时刻,我们的机器在识别物体方面已经超过了人类,人类犯的错误比机器更多。这是一个非常有力的证明,表明我们能够在特定领域达到人类的表现水平。不过这个领域非常狭窄,对吧?只是对图片中的事物进行分类。
而对于我们今天看到的这种更通用的人工智能,转折点出现在我收到合作者的一封邮件时,他是Transformer论文的共同作者Lukasz Kaiser。邮件里写道:“快看这个。”那是一篇维基百科文章,标题是“The Transformer”。文章接着讲述了一支日本朋克摇滚乐队的故事:乐队组建、解散,贝斯手去了别处。而在文章的最底部,Lukasz写道:“我刚写了‘The Transformer’,剩下的都是机器写的。”
那是一个超现实的时刻,你看到机器能够如此流利地说话,以至于让我相信我读的是一篇关于日本朋克摇滚乐队的文章。那就是大型语言模型的“尤里卡时刻”。
Robin Pomeroy:那支乐队并不存在?
Aidan Gomez:不存在。那都是它编造的。但它的表达非常流利。它真正能够使用语言,而在此之前没有任何东西能真正做到这一点。
Robin Pomeroy:我想,这大概也是过去一年左右,“普通大众”通过ChatGPT和其他应用所获得的体验。就像在说:哇,我们从未有过被机器与之交谈的这种体验。
Aidan Gomez:是的。而且它远比我当年见到的要好得多。它更加正确、准确,也更加真实。而且它能做的事情也更多。
所以,我们当时构建的那些模型,只是擅长编写虚假的维基百科页面。而现在,这些模型能够完成很多真正有趣且颇具挑战性的任务。
Robin Pomeroy:无论是有形的东西,还是遥远未来的某种事物,有什么是真正让您感到兴奋的?比如,您能够使用生成式人工智能做到的某件事,会让您觉得:哦,等我能做到那件事时,一定会非常精彩?
Aidan Gomez:对我来说,我认为是提升生产力。它没有被过度炒作,人们也不太谈论它,但它的影响非常深远。
举个例子,医生。我认为他们大约有40%的工作时间用于写病历。如果我们能把这40%的时间还给他们,让他们把时间用于陪伴患者、关注患者的治疗结果,这实际上意味着,一夜之间我们就等于将医生的有效数量翻了一番。在这类职业中,人类的供给极为紧张。如果我们能够缓解这种供给约束,人们就能活得更久,生活得更好,我们也能挽救更多生命。所以,我认为这并不是被当作一种噱头式的、令人兴奋的东西来谈论的。
Robin Pomeroy:这可不是科幻小说吧!生产力的提升。不过这是一个很好的回答。那么反过来呢?生成式人工智能的发展有没有什么真正让您担忧的地方?
Aidan Gomez:有的。我认为今年,世界将迎来大量选举,我非常担心这项技术在改变公共舆论方面的能力。它可以大规模地植入大量与人类完全无法区分的机器人账号,要么让某个观点看起来比实际上更受欢迎,要么朝着期望的方向扭曲讨论。
因此,我认为我们都需要大声呼吁,阻止这类技术的发展。
确实有一些技术可以帮助防范这种情况。例如,几乎所有社交媒体平台都在实施人类身份验证。这样,你现在就能看到屏幕另一端的人已被“验证为人类”。你就会知道,你交谈的对象是地球上另一位有投票权的公民。
我认为这方面还需要更多努力,并且需要更积极地推进,因为这项技术确实让人造草根运动(astroturfing)变得容易得多。
Robin Pomeroy:这位是Cohere联合创始人Aidan Gomez。我们将在Radio Davos的后续一期节目中听到他更多的观点,该期节目将聚焦人工智能治理问题。
顺便说一下,所谓人造草根运动(astroturfing),就是策划一场虚假的活动,让人看起来某件事情拥有广泛的草根支持。
如果您想入门了解人工智能,不妨读一读Mustafa Suleyman的《即将到来的浪潮》。他曾在达沃斯的一场小组讨论中发言,正如他在书中所写的那样,他有力地论证了人工智能的变革性力量。
Mustafa Suleyman:这将是我们有生之年最具变革性的时刻,不仅在科技领域,在文化和政治领域也是如此。
我们将见证动力成本的急剧下降。
人工智能的本质,是吸收海量信息、生成新型信息,并基于这些信息采取行动的能力。这与任何组织,无论是政府、公司还是个人,的运作方式并无二致,这也是我们所有人与世界互动的方式。
我们正在将其商品化,也就是降低生产和分发这一工具的成本。最终,它将广泛惠及每一个人,有可能以开源或其他形式提供,而这将带来极大的不稳定性。
因此,无论从哪个角度看,它都有着令人难以置信的好处。同时,它也有可能让每个人都能够以某种方式对抗,因为我们对世界持有不同的观点和意见。
这一新浪潮的一个显著特征是,这些工具具有全能用途,“两用”一词已经不足以形容它们了。它们在众多不同场景中都具有内在的实用价值。
事实上,回顾历史,每一项改变世界的通用技术都有一个非常一致的特征:只要它变得有用,就会变得更便宜、更容易使用,并广泛传播。
因此,我们必须假定,在未来几十年里,这将继续是它的发展方向,并管理好这种力量所带来的后果:采取行动的能力变得越来越便宜,并广泛惠及每一个人,无论是“好”的用途还是所谓“坏”的用途。
Robin Pomeroy:在他的书《即将到来的浪潮》中,Mustafa Suleyman谈到了图灵测试,这是一种长期以来用于检验机器是否具备类人智能的方法。该测试以英国计算机科学家Alan Turing的名字命名,他于1950年提出了这一测试。图灵测试考察的是,机器能否以一种与人类回答无法区分的方式回答问题。
由于当前我们都能使用的人工智能聊天机器人基本上已经能够通过这一测试,Suleyman在书中提出,更新版的图灵测试应当检验人工智能系统不仅能否表现出智能,还能否完成一项真实而复杂的任务。他建议使用以下提示语:“请在几个月内用仅10万美元的投资在亚马逊上赚取100万美元。”
下面是他在达沃斯那场名为“人工智能的硬实力”(Hard Power of AI)的论坛上的发言:
Mustafa Suleyman:我们已经有了70多年的图灵测试,其目标是尝试模仿人类对话,并说服人类相信你实际上是人类,而不是人工智能。
事实证明,我们现在已经非常接近通过这一测试。也许在某些场景中我们已经做到了,尚不清楚,但它显然已不再是一项有用的测试。
因此,我认为正确的测试,即一种现代图灵测试,应当评估人工智能能否像企业家那样行事,比如像一位小型项目经理,或一种新产品的发明者,去推向市场、生产、销售等,从而实现盈利。
我非常确信,在未来五年内,最迟在本十年结束前,我们不仅将拥有这些能力,而且这些能力还将以极低的成本广泛可得,甚至可能以开源形式提供。我认为这将彻底改变经济。
Robin Pomeroy:Mustafa Suleyman是Inflection AI的联合创始人,也是《即将到来的浪潮》的作者。您可以在我们的姊妹节目Agenda Dialogues中收听完整对话,其中还包括许多其他关于人工智能的有趣嘉宾。该节目名为“人工智能的硬实力”(Hard Power of AI)的论坛环节中。
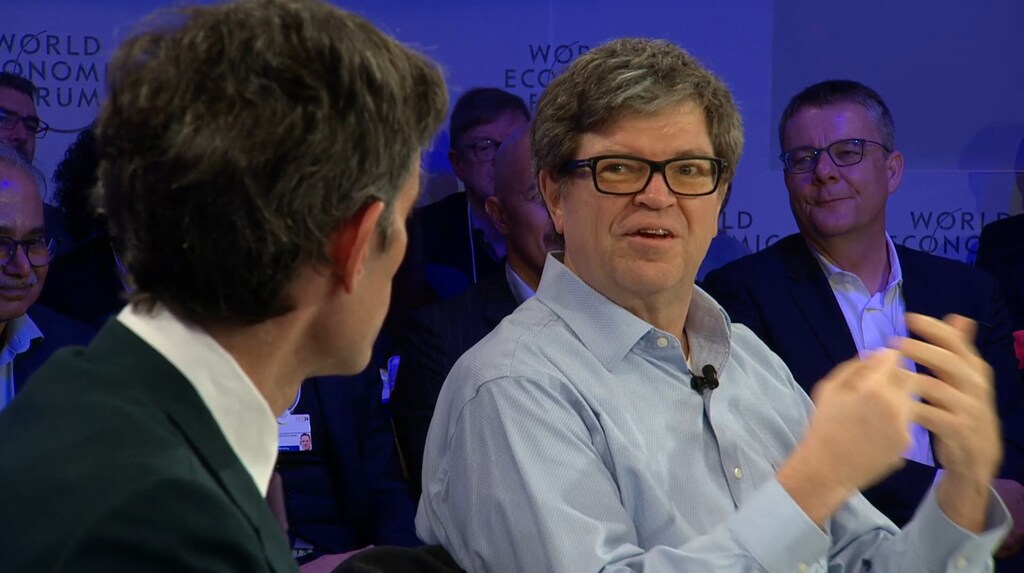
我们的第三位智者是Yann LeCun,他是一位引人入胜的人物,经常公开批评围绕人工智能的炒作。因此,当我的同事Colm Quin在达沃斯与他坐下交谈时,他对“未来十年人工智能将如何重塑各行各业”这一问题给出了审慎的回答。
Yann LeCun:我叫Yann LeCun,既然我们在这一边的大西洋上,我是Meta的首席人工智能科学家,同时也是纽约大学的教授。
Colm Quin:未来十年,生成式人工智能将如何重塑各行各业?
Yann LeCun:未来十年将发生大量重塑,部分原因在于生成式人工智能,部分原因则在于非生成式人工智能。
目前人人都在谈论的,是用于文本、图像,并且很快也将用于视频和音乐的生成式人工智能。这将使人们变得更有创造力,让更多的人更有创造力,因为这是一种全新的创作方式。它还将帮助那些不一定掌握相关技巧的人,在各个方面发挥创造力。
当然,这对商业将大有帮助。许多需要撰写文字的职业,都将借助能够流利使用语言的生成式系统而获得帮助。
这大致是短期的情况。它将使许多人变得更高效、更有创造力。
但还有长期情况,长期而言,这些系统将变得越来越聪明,而且其架构也将有所不同。它们不会是我们在过去一年里已经习惯的那种自回归大型语言模型。它们很可能会基于不同的蓝图构建。这些系统将能够理解物理世界,而当前的系统做不到这一点。它们将能够记忆,而当前的系统同样做不到,并且它们将能够推理和规划,这也是当前系统所不具备的。
因此,一旦我们实现这些突破,而这些突破将在未来几年内出现,我们将拥有比现在聪明得多的系统,其影响深远,后果也很难预测。
Colm Quin:能够理解物理世界的人工智能,稍作推测,您认为它会是什么样子?
Yann LeCun:首先,我需要解释一下,为什么我们当前的系统无法理解物理世界,以及为什么目前的人工智能系统在与人类和动物所展现的智能与学习能力相匹配方面仍然差距非常大。
原因在于,语言并不是对世界的完整表征。我们作为婴儿时学到的大部分东西,都来自与物理世界的互动,而不是来自文本。
我们认为文本确实包含了人类的全部知识,但事实并非如此。我们头脑中的大部分知识,实际上都来自与物理世界的互动。
原因非常简单。如果你看一个大型语言模型,它是在整个公共互联网的文本上训练的,大约有10万亿个词。我的意思是,实际上是标记(token),但可以理解为词。每个标记大约是两个字节,所以你用来训练这些系统的数据,是两后面跟13个零的字节,也就是2×10^13字节。你可以想象,这是一个令人难以置信的信息量,因为无论是你还是我,要把它全部读完,大约需要15万至20万年。所以,它的规模大得难以想象。
但如果我们计算一下,一个四岁儿童在四岁时,有多少信息进入了他的视觉皮层。这个四岁的孩子已经清醒了16,000个小时,将其乘以每小时3,600秒,再乘以大约每秒20MB的信息量,即通过视神经传输的数据量,结果是10的15次方字节。也就是说,这大约是50倍。
一个孩子在四岁时,通过视觉接收到的信息量,是我们最大的大型语言模型的15倍。因此,嵌入这些数据中的知识量是巨大的。实际上,它比文本中所包含的知识量要大得多。而我们尚不知道如何在机器中实现这一点。我们不知道如何让它们观察世界的运行,学习世界如何运作,并获得常识、直觉物理学以及类似的东西。
这是未来几年的挑战,我们正在为此努力。我们不知道下一个突破何时会出现。我们正在取得进展。但在我们拥有能够利用这些成果的东西之前,可能还需要几年,甚至更久。
然而,到那时,我们将拥有能够学习世界如何运作的系统,或许还能理解人们以及驱动人们的动机。因此,这些系统将能够规划一系列行动,以实现特定目标。
也就是说,你给它们一个目标,它们就能思考这一目标,并规划出一系列能够实现该目标的行动,同时也可能满足一些使系统保持安全的护栏要求。
我把这称为目标驱动型人工智能。我无法向你展示一个例子,因为它目前还不能运行。但这可能就是未来的方向。
这些系统将是可控、安全的。它们将理解世界,它们将能够记忆。这种规划能力将使它们能够进行推理,完成当前系统无法完成的所有事情。
因此,我们距离真正拥有具备高度智能的系统仍然很远,但我们有望实现这一目标,届时人们将每天与这些事物互动。它们会出现在人们的智能眼镜中,而人与数字世界的界面将是一个人工智能系统。
Colm Quin:您之前曾说过,每个人的互动都将由人工智能进行中介。您能否具体地描述一下,这在现实中会是什么样子?
Yann LeCun:好的。目前,如果我们想获取信息,就必须选择使用哪种服务。我们去搜索引擎,浏览各种社交媒体,或者去维基百科之类的网站。
但你将随时拥有一位随身助手。这位助手了解你,是你最好的数字朋友,如果你愿意,也可以说是你的私人助理。在某个时刻,它将具备与人类相当的智能水平,因此基本上会像人类助理一样行事,或者与之非常接近。这不会在明天实现,需要一段时间。
但是,你将拥有智能眼镜。你将能够与它交谈,它将能够通过语音或显示屏进行回应。你也可以通过打字等各种方式与它互动。
如果你看过电影《她》(Her),那是Spike Jonze十年前拍摄的电影,它对这种助理概念的描绘还算不错。
最终,这些系统将比我们更聪明。因此,它就不再像拥有一位助理,而更像是拥有一支由非常聪明的人组成的团队与你一起工作,为你赋能,并在某种程度上放大人类的智能。
因此,这可能会使每个人整体上变得更聪明。你知道,人们与他们的虚拟助理团队相结合,如果你愿意这样说的话。而这可能会是人类的一次新文艺复兴。
Colm Quin:您认为围绕生成式人工智能,最紧迫的伦理问题是什么?企业应当如何看待这些问题?
Yann LeCun:好的,有很多不同的方面。
无论在行业的哪个角落,显而易见的益处都是存在的,对吧?未来几年事情将会发生变化。因此,认为我们现在所了解的这类大型语言模型将继续存在,并带来人工智能的所有其他特性,这种想法是错误的。
这就是为什么在几年内会出现不同的东西。我们将以类似的方式与它们互动,但它们会强大得多。这是第一点。
第二点是人工智能的平台必须是开源的。当然,专有系统也有其存在的空间,但它们最终必须是开源的,因为它们终将构成全人类知识的储存库。不能由某一家私营公司来打造这样的系统,使其涵盖语言、文化、价值体系和关注焦点的全部光谱。
因此,我们需要大量相对多样化(而非专门化)的人工智能平台,为人们提供多元的信息来源。我们不能只有单一的信息来源。因为如果我们所有的数字信息摄取都由单一的人工智能系统中介,那对文化多样性和政治观点等方面意味着什么呢?
所以它必须是多元的,这意味着这些平台(因为训练成本极其高昂)必须是开源的。
这正是Meta、几乎整个学术界、许多初创企业,当然还有风险投资界所采纳或接受的立场,而且许多国家也在拥抱这一立场,因为它们将开源人工智能平台视为保护本国文化的途径,某种程度上也是实现人工智能主权的途径。
因此,我的预测是,它将像互联网的软件基础设施一样。它必须是开源的,因为这是其在全球范围内传播最高效的方式。
Colm Quin:您认为这种开源方式是否会带来监管挑战?我想,比方说,如果它落入不良分子之手呢?
Yann LeCun:这是一场非常重要的、一直在进行的辩论。目前正在形成的共识是(半年前还不是这样),各方都认同开源是一件好事,不应因监管而被扼杀。
当然,坏人可能会获取它,但防范之道在于你要持续前进,确保坏人不会领先于你,对吧?
如果你对研发进行监管,研发就会放缓。而坏人将会迎头赶上,他们总会以某种方式获取它。
如果你保持领先,你的应对措施就会优于他们的攻击。
在Meta,我们非常熟悉如何利用人工智能来对抗虚假信息、仇恨言论、儿童剥削、恐怖主义宣传,你知道的,还有人们想利用的各种可怕行为……你知道的,选举舞弊之类的事情。
我认为,重大问题既是技术问题,更是行业和标准问题,即如何防止深度伪造。
世界上三个最大的民主国家——美国、印度和印度尼西亚——即将迎来重大选举。许多政治候选人担心,我们可以制作出他们从未说过的话的虚假视频。
如今,这些视频在一定程度上是可以被识别的,但并非完全可以。因此,业界一直在讨论水印标准等方案,但目前尚未出现真正有效的技术解决方案。至于应当为哪类内容加水印,是人工智能生成的内容,还是相反地为真实内容加水印,这仍是一个问题。如果要为真实内容加水印,从而表明其是否经过了严重篡改,就需要相机制造商的参与,需要所有视频处理软件的参与,诸如此类。这非常困难。这些措施要真正落地,还需要相当长的时间。
所以,短期内最大的问题可能是如何解决这一难题。
我认为,公众也将逐渐认识到,某些信息来源是可以信任的,而另一些则绝对不应相信。
我认为,将会发生的情况有点类似于电子邮件的发展历程。在电子邮件的早期,出现了垃圾邮件,也出现了垃圾邮件过滤器。随后,人们学会了忽略垃圾邮件,仅凭主题就能判断它是垃圾邮件。如今,现代邮件系统在你看到之前就已将其清除。接着出现了诈骗邮件。我们都知道电子邮件中常见的诈骗手法是什么。人们逐渐学会了不要随便点击任何东西。
因此,我认为这将是一个类似的现象,但问题是需要多长时间?会有多少人被这些虚假内容所蒙骗?为防范这一问题,将会部署哪些技术系统,又将以多快的速度部署?这才是重大问题。
Robin Pomeroy:这位是纽约大学教授、Meta首席人工智能科学家Yann LeCun。在他之前,你听到的是Inflection AI的Mustafa Suleyman和Cohere联合创始人Aidan Gomez。
关于达沃斯论坛上人工智能的更多内容,请访问 wef.ch/wef24 浏览。
请务必查看世界经济论坛的人工智能治理联盟,网址为 wef.ch/AIGA,请注意字母须全部大写。
我们还有多期与该主题相关的播客节目,可访问 wef.ch/podcasts 查看全部节目,或在您的播客应用中搜索我们的节目《Radio Davos》《Meet the Leader》和《Agenda Dialogues》。
本期《Radio Davos》节目由我Robin Pomeroy主持,Colm Quin提供了补充报道。达沃斯现场的录音工程由Juan Toran和Edward Bally负责。声音制作由Taz Kelleher负责。
下周我们将再次与您相见,现在感谢您的收听,再见。
向下滚动查看完整播客文字稿,点击“显示更多”箭头
“这将是我们这一代人中最具变革性的时刻,不仅体现在技术领域,也体现在文化和政治领域。”
三位人工智能先驱,他们都是《时代》周刊百大人物中对人工智能最有影响力的人物,分享他们对这项变革性技术的过去、现在和未来的看法。
嘉宾:
Aidan Gomez,Cohere联合创始人兼首席执行官
Mustafa Suleyman,Inflection AI联合创始人兼首席执行官
Yann LeCun,Meta首席人工智能科学家
链接:
世界经济论坛人工智能治理联盟:wef.ch/AIGA
相关播客:
2023年是我们所有人开始认识人工智能的一年——那么2024年它将把我们带向何方?
欢迎在以下网址查看我们的全部播客:wef.ch/podcasts:
YouTube: - https://www.youtube.com/@wef/podcasts
Radio Davos - 订阅:https://pod.link/1504682164
Meet the Leader - 订阅:https://pod.link/1534915560
Agenda Dialogues - 订阅:https://pod.link/1574956552
World Economic Forum Book Club Podcast - 订阅:https://pod.link/1599305768
加入世界经济论坛播客俱乐部:https://www.facebook.com/groups/wefpodcastclub